
Dans ce guide
Comment procéder
Ouvrez un PDF numérisé lisible. Sélectionnez jusqu'à 10 pages pour cette opération OCR ; le PDF source peut contenir jusqu'à 80 pages.
Choisissez l'allemand ou l'anglais comme langue de reconnaissance et exécutez l'OCR.
Recherchez un mot dont vous savez qu'il se trouve sur la page. Vérifiez les noms, les chiffres et les caractères spéciaux par rapport à la numérisation visible.
Entrée, résultat et limites
| Caractéristique | Détails |
|---|---|
| Entrée | |
| Sortie | |
| Limite importante | OCR allemand ou anglais ; jusqu’à 10 pages choisies. |
Le parcours en six vues
1Entrée
Ouvrez un PDF numérisé lisible. Sélectionnez jusqu'à 10 pages pour cette opération OCR ; le PDF source peut contenir jusqu'à 80 pages.
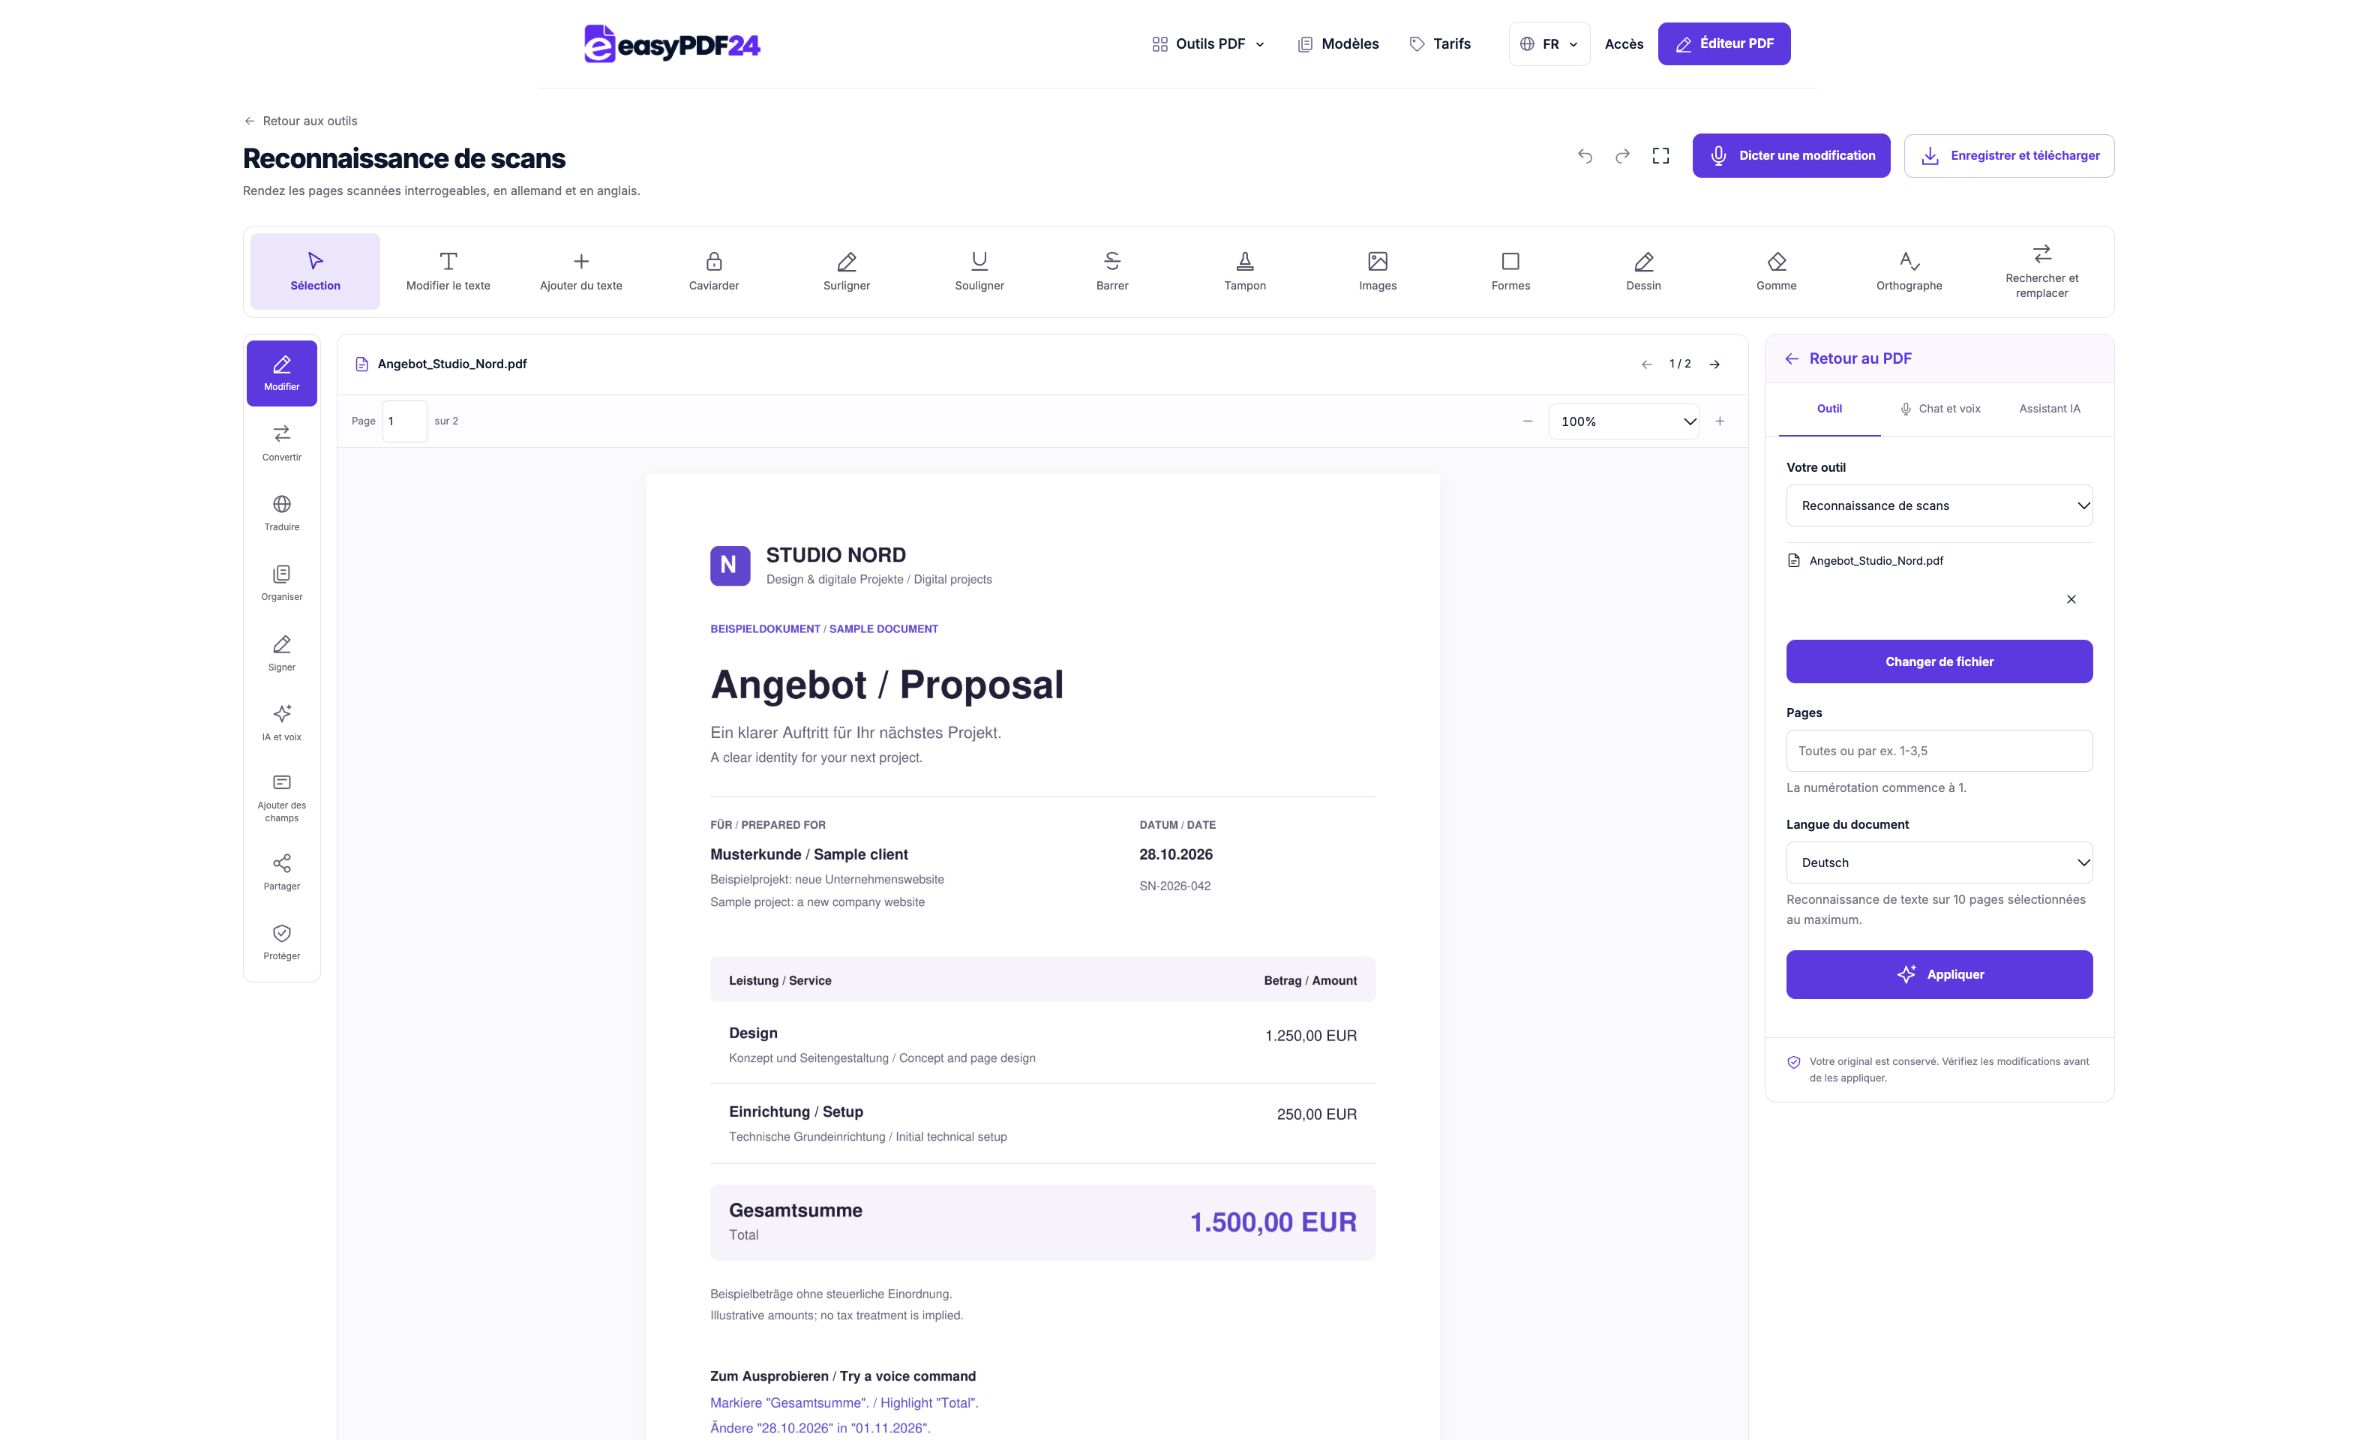
2Réglages
Choisissez l'allemand ou l'anglais comme langue de reconnaissance et exécutez l'OCR.
3Appliquer
PDF → PDF
4Avant et après
Page visuelle → Texte extrait
5Vérifier
Comparer noms, nombres et caractères spéciaux Contrôler l’ordre de lecture et les paragraphes Rouvrir le fichier téléchargé
6Enregistrer
Recherchez un mot dont vous savez qu'il se trouve sur la page. Vérifiez les noms, les chiffres et les caractères spéciaux par rapport à la numérisation visible.
Exemple
Avant
Page visuelle
Après
Texte extrait
Vérifiez ces points dans le résultat
- Comparer noms, nombres et caractères spéciaux
- Contrôler l’ordre de lecture et les paragraphes
- Rouvrir le fichier téléchargé
Décidez si le PDF a besoin d'une reconnaissance de texte
L'OCR est utile lorsqu'une page contient une image d'écriture plutôt qu'un texte utilisable. La numérisation d'une lettre imprimée en est un exemple courant. Les lettres semblent lisibles par une personne, mais une recherche ordinaire peut ne rien trouver car le PDF stocke des pixels. L'OCR tente de reconnaître ces formes et ajoute du texte qu'une visionneuse PDF peut rechercher ou sélectionner.
Essayez une simple vérification avant de traiter le document. Recherchez un mot distinctif visible sur la page et essayez de sélectionner une phrase courte. Si les deux fonctionnent correctement, la page peut déjà contenir un calque de texte utilisable. Ne pas trouver un mot ne prouve pas que toutes les pages sont des images : une orthographe, un encodage inhabituel ou un caractère stocké différent peuvent également affecter une recherche. Inspectez plus d’un endroit.
Un PDF mixte peut contenir à la fois des pages numériques et des pièces jointes numérisées. easyPDF24 ignore les pages qui contiennent déjà du texte plutôt que de leur ajouter un deuxième calque. Cela permet d'éviter le texte en double, mais cela signifie également que l'OCR n'est pas un outil de réparation général pour un calque de texte existant de mauvaise qualité. Identifiez les pages qui nécessitent une reconnaissance et vérifiez le résultat sur ces pages au lieu de vous attendre à ce que chaque partie du fichier soit reconstruite.
Préparez une numérisation nette avant l’OCR
La reconnaissance commence par ce qui est visible. Des lettres imprimées claires, une page raisonnablement droite et un contraste constant confèrent à l'outil un meilleur matériau avec lequel travailler. Un texte flou, une ombre sur un chiffre ou un coin plié peuvent laisser une ambiguïté que le logiciel ne peut pas résoudre de manière fiable. Si vous avez accès au papier ou à une meilleure source de numérisation, l'amélioration de la saisie peut être plus efficace que le traitement répété de la même image de mauvaise qualité.
Vérifiez la page entière, y compris les petits caractères sur les bords. Une photographie d'appareil photo peut paraître nette au centre mais perdre des détails près d'une reliure incurvée. Un tampon peut couvrir une partie d’un mot et une note au crayon pâle peut disparaître à l’arrière-plan. Enregistrez les zones qui nécessitent un examen spécial afin de ne pas supposer qu'une recherche réussie dans le titre prouve que le pied de page a été reconnu correctement.
Utilisez l'outil de rotation si une page est orientée dans la mauvaise direction. La rotation quart de tour est différente du redressement d’une image légèrement inclinée ou de la correction de la perspective de la caméra. easyPDF24 ne promet pas de réparer automatiquement chaque problème de capture. Préparez la contribution pratique la plus claire et conservez l’original visible pour comparaison. La sortie OCR doit être vérifiée par rapport à cette source, en particulier lorsque vous avez l'intention de réutiliser des noms, des dates ou des montants.
Choisissez la langue prise en charge et la sélection de pages
L'aperçu OCR actuel prend en charge l'allemand et l'anglais imprimés. La langue de ce guide, de la navigation ou du paiement n'étend pas les langues de reconnaissance. Choisissez la langue qui correspond au texte numérisé. Pour un document contenant plusieurs langues, travaillez avec des sélections appropriées lorsque cela est possible et inspectez attentivement les passages multilingues ; la reconnaissance linguistique non prise en charge n'est pas une fonctionnalité promise.
Un PDF source peut contenir jusqu'à 80 pages, mais une opération OCR n'accepte pas plus de dix pages sélectionnées. Utilisez le champ de sélection de page pour choisir les pages dont vous avez besoin, par exemple 1 à 5 et 8. Les positions correspondent aux numéros de page réels du PDF, en commençant par sa première page, plutôt qu'aux numéros imprimés à l'intérieur du document. Une couverture peut décaler ces deux systèmes de numérotation.
Pour une source plus longue, effectuez une autre sélection après avoir vérifié le premier résultat. Gardez une trace de la version de travail qui contient les sélections terminées. Les petits lots facilitent également la révision : si une numérisation de mauvaise qualité produit des erreurs, vous les découvrez avant de vous fier aux pages restantes. Il n'y a aucun avantage à traiter des pages qui ne sont pas pertinentes pour votre tâche simplement parce qu'elles sont incluses dans le fichier d'origine.
Comprendre la page visible et son calque de texte
Après la reconnaissance, la page doit encore être vérifiée visuellement par rapport au scan. Le texte consultable est une représentation supplémentaire de ce que l’outil pense que l’image dit. C'est utile pour retrouver un paragraphe ou copier un passage, mais ce n'est pas une confirmation indépendante que chaque caractère a été lu correctement. L'image visible reste votre référence pour vérifier des lectures incertaines.
Cette distinction est importante pour les détails sensibles. Un résultat de recherche peut sauter à l'endroit attendu alors que la phrase copiée contient un chiffre erroné. Une ligne de texte peut également être reconnue dans un ordre gênant lorsqu'elle s'étend sur des colonnes ou se trouve à côté d'une légende. Comparez à la fois la position et les caractères réellement extraits. Un résultat de recherche mesure à lui seul si quelque chose a été trouvé, et non si la page entière est exacte.
L'OCR ne transforme pas automatiquement une mise en page numérisée complexe en un document source entièrement modifiable. Il ne reconstruit pas chaque cellule du tableau, ne recrée pas la collection de polices d'origine et ne fournit pas un ordre de lecture garanti pour les conceptions de pages complexes. Si votre prochaine tâche consiste en une réécriture substantielle, utilisez le texte reconnu comme matériau pour un document que vous révisez et formatez. Gardez le PDF disponible pendant que vous effectuez ce travail afin que les références restent faciles à vérifier.
Travaillez sur un exemple pratique de reconnaissance
Imaginez un rapport numérisé de huit pages en anglais. Vous devez localiser trois références de projet et copier un court paragraphe de la page 6. Vérifiez d'abord que les références et le paragraphe sont lisibles dans les images. Rechercher dans le PDF existant ; si les pages requises ne contiennent pas de texte utilisable, sélectionnez ces pages pour l'OCR au lieu de supposer que chaque page doit être traitée.
Exécutez la reconnaissance avec l'anglais sélectionné. Dans le résultat, recherchez une référence de projet exactement telle qu’imprimée, puis inspectez la page correspondante. Copiez le paragraphe dans un champ de texte temporaire et comparez-le ligne par ligne avec la numérisation. Vérifiez la ponctuation autour des dates, l’ordre des clauses et tout code de référence. Un code tel qu'une lettre suivie de plusieurs chiffres mérite une attention particulière, car une erreur apparemment plausible peut être facile à ignorer.
Si le paragraphe traverse une limite de page, inspectez les deux côtés de cette limite. Une dernière ligne manquante peut changer le sens même si le paragraphe principal semble correct. Enregistrez le PDF reconnu lorsqu'il remplit la tâche et conservez une note séparée de tous les caractères que vous avez corrigés dans le texte réutilisé. Cela permet de retracer plus facilement votre document ultérieur jusqu'à la source visible sans prétendre que l'OCR a vérifié le contenu pour vous.
Vérifiez les nombres, les noms et l’ordre de lecture
Donnez la priorité au contenu pour lequel une petite erreur a un effet important. Les noms, identifiants de référence, quantités, pourcentages, dates et séparateurs décimaux doivent être vérifiés caractère par caractère lorsqu'ils sont importants pour l'action suivante. Des formes similaires telles que zéro et la lettre O, ou un et un l minuscule, sont des sources courantes d'ambiguïté dans les numérisations de mauvaise qualité. La lecture correcte vient du contexte source et de l’image, et non de la fluidité du son de sortie.
Pour les tableaux, inspectez une ligne complète dans toutes les colonnes. L'extraction de texte peut mettre une valeur à côté du mauvais titre même lorsque chaque numéro individuel a été reconnu. Ne déduisez pas une feuille de calcul reconstruite à partir de l’apparence d’un texte tabulaire. Si vous avez besoin de calculs, reconstruisez et vérifiez le tableau dans une application appropriée plutôt que de traiter une exportation en texte brut comme une structure de données fiable.
Pour les colonnes et les notes de bas de page, lisez le passage copié du début à la fin. Vérifiez si le texte suit la colonne prévue avant de passer à la suivante et si une note de bas de page a été insérée au milieu d'une phrase. Il s’agit de problèmes d’ordre de lecture plutôt que de simples fautes d’orthographe. Ils nécessitent une révision éditoriale du passage, et pas seulement une recherche de personnages inhabituels.
Choisissez la bonne prochaine étape après l'OCR
Si vous avez uniquement besoin de localiser des informations dans le PDF, une version vérifiée et consultable peut suffire. Vous pouvez rechercher des termes distinctifs et lire la page originale de chaque résultat. Évitez de convertir vers un autre format sans raison, car chaque représentation supplémentaire introduit un autre résultat à examiner. Un PDF avec une recherche utile peut déjà résoudre une tâche d'archivage ou de référence.
Si vous avez besoin de texte réutilisable, l'outil PDF vers Word exporte le texte sélectionnable pris en charge dans un simple document DOCX. Il ne promet pas de reproduire la mise en page, les tableaux ou les images d'origine. Ouvrez le DOCX dans un éditeur compatible, organisez les titres et les paragraphes, puis comparez les passages importants avec le PDF reconnu. La reconnaissance et le formatage du document sont des étapes distinctes, chacune avec ses propres contrôles.
Pour une petite correction, étudiez les opérations de texte prises en charge par l'éditeur, mais ne supposez pas que chaque mot visible dans une image est désormais librement modifiable sur place. L'apparence numérisée et le comportement du calque de texte peuvent différer. Lorsqu'une image elle-même doit être modifiée, utilisez une zone ou une opération d'image appropriée et inspectez le résultat visuel. L'OCR est une voie vers un texte consultable, et non un substitut universel à tout type d'édition de PDF.
Dépanner un résultat vide ou décevant
Si la reconnaissance produit peu de texte utile, inspectez d’abord la source avec un zoom plus grand. L'impression est-elle suffisamment nette pour être lue ? La langue choisie est-elle prise en charge ? La page contient-elle une écriture manuscrite, des lettres inhabituelles ou un tableau dense plutôt que des paragraphes imprimés ordinaires ? Ces questions permettent d'identifier si la saisie est adaptée avant de répéter la même opération avec des paramètres identiques.
Si une page contient déjà du texte, il peut être ignoré. Cela peut expliquer pourquoi l'OCR n'améliore pas une couche précédemment reconnue mais inexacte. Vérifiez le résultat de la sélection et de la copie du texte à partir de la page d'origine. Un petit élément de texte peut également rendre une page différente d'une numérisation entièrement composée uniquement d'images. Ne promettez pas qu’un nouveau passe de reconnaissance remplacera chaque représentation textuelle existante.
Si seules certaines pages sont erronées, isolez ces pages pour les réviser plutôt que de rejeter un résultat utile ailleurs. Revérifiez votre sélection par rapport au compteur de pages de l'éditeur, puis comparez les pages attendues dans la sortie. Pour les zones systématiquement illisibles, obtenez une meilleure numérisation lorsque cela est possible. La vérification manuelle d’un court passage nécessaire peut être plus fiable que l’utilisation d’une longue transcription non vérifiée simplement parce qu’elle a été générée automatiquement.
Gardez les corrections et le matériel source distincts
Lorsque l'OCR prend en charge la recherche, l'administration ou la préparation de documents, séparez ce que dit visiblement la source de toute formulation que vous corrigez ou réécrivez ultérieurement. Le texte reconnu peut contenir une erreur de lecture automatique, tandis que la source elle-même peut contenir une faute de frappe originale. Réparer ces deux choses répond à des objectifs différents. Gardez suffisamment de contexte pour comprendre si votre nouvelle formulation est une transcription fidèle ou une révision éditoriale.
Utilisez des noms de fichiers clairs pour la numérisation source, la copie consultable et tout brouillon Word ultérieur. Vous n'avez pas besoin d'un système d'archives compliqué pour éviter toute confusion ; un suffixe descriptif et une date cohérents peuvent suffire. Ce qui compte, c'est de pouvoir identifier quel fichier contient l'image source et lequel inclut vos modifications ultérieures. Ne remplacez pas votre seule copie de l’original par une exportation non contrôlée.
Enregistrez un résultat que vous souhaitez conserver sur votre propre appareil. L'OCR n'est pas un service de stockage permanent. Si le document contient des informations qui ne doivent pas être téléchargées vers easyPDF24, choisissez un flux de travail alternatif approprié avant de le traiter plutôt que de traiter la reconnaissance comme quelque chose qui ne se produit nécessairement que dans votre navigateur.
Vérifier le document pour son utilisation prévue
Une vérification finale utile est basée sur ce que vous envisagez de faire avec le résultat. Pour la recherche, testez plusieurs mots distinctifs sur différentes pages traitées. Pour la copie, comparez un paragraphe complet et une ligne difficile contenant des chiffres. Pour une conversion ultérieure, ouvrez également ce fichier converti et inspectez l'ordre et l'exhaustivité de son contenu. Chaque chèque répond à une question pratique différente.
N'utilisez pas une seule recherche de mots réussie comme score de qualité pour l'ensemble d'un document. Un titre clair peut être facile à reconnaître tandis que les petites notes de bas de page restent inexactes. Échantillonnez différentes parties de la page, puis inspectez tous les détails dont dépend votre tâche. Lorsque l’exactitude est essentielle, l’examen nécessaire peut être plus approfondi qu’un échantillon rapide ; l'outil ne peut pas décider quel caractère erroné serait le plus important pour vous.
Une fois que les pages sélectionnées sont satisfaisantes, téléchargez le PDF consultable via le flux de paiement disponible et rouvrez le fichier enregistré. Confirmez que la recherche fonctionne dans la visionneuse que vous utiliserez ensuite. Vous disposez alors d’un document de travail vérifié dans un but défini, plutôt que d’une transcription non vérifiée dont l’apparence seule suggère qu’elle doit être correcte.
Questions fréquentes
Quelles langues cet outil OCR prend-il en charge ?
easyPDF24 prend en charge l'allemand et l'anglais. Un guide rédigé dans une autre langue ne signifie pas que l'OCR prend en charge cette langue.
Puis-je traiter un document de plus de 10 pages ?
Oui, dans la limite de 80 pages. Ne choisissez pas plus de 10 pages par opération OCR, puis procédez à une autre sélection si nécessaire.