
W tym poradniku
Jak to zrobić
Otwórz czytelny zeskanowany plik PDF. Wybierz do 10 stron dla tej operacji OCR; źródłowy plik PDF może zawierać do 80 stron.
Wybierz niemiecki lub angielski jako język rozpoznawania i uruchom OCR.
Wyszukaj znane Ci słowo, które znajduje się na stronie. Sprawdź nazwy, numery i znaki specjalne na widocznym skanie.
Dane, wynik i ograniczenia
| Właściwość | Szczegóły |
|---|---|
| Dane wejściowe | |
| Wynik | |
| Ważne ograniczenie | OCR niemiecki lub angielski; do 10 wybranych stron. |
Przebieg w sześciu widokach
1Dane wejściowe
Otwórz czytelny zeskanowany plik PDF. Wybierz do 10 stron dla tej operacji OCR; źródłowy plik PDF może zawierać do 80 stron.
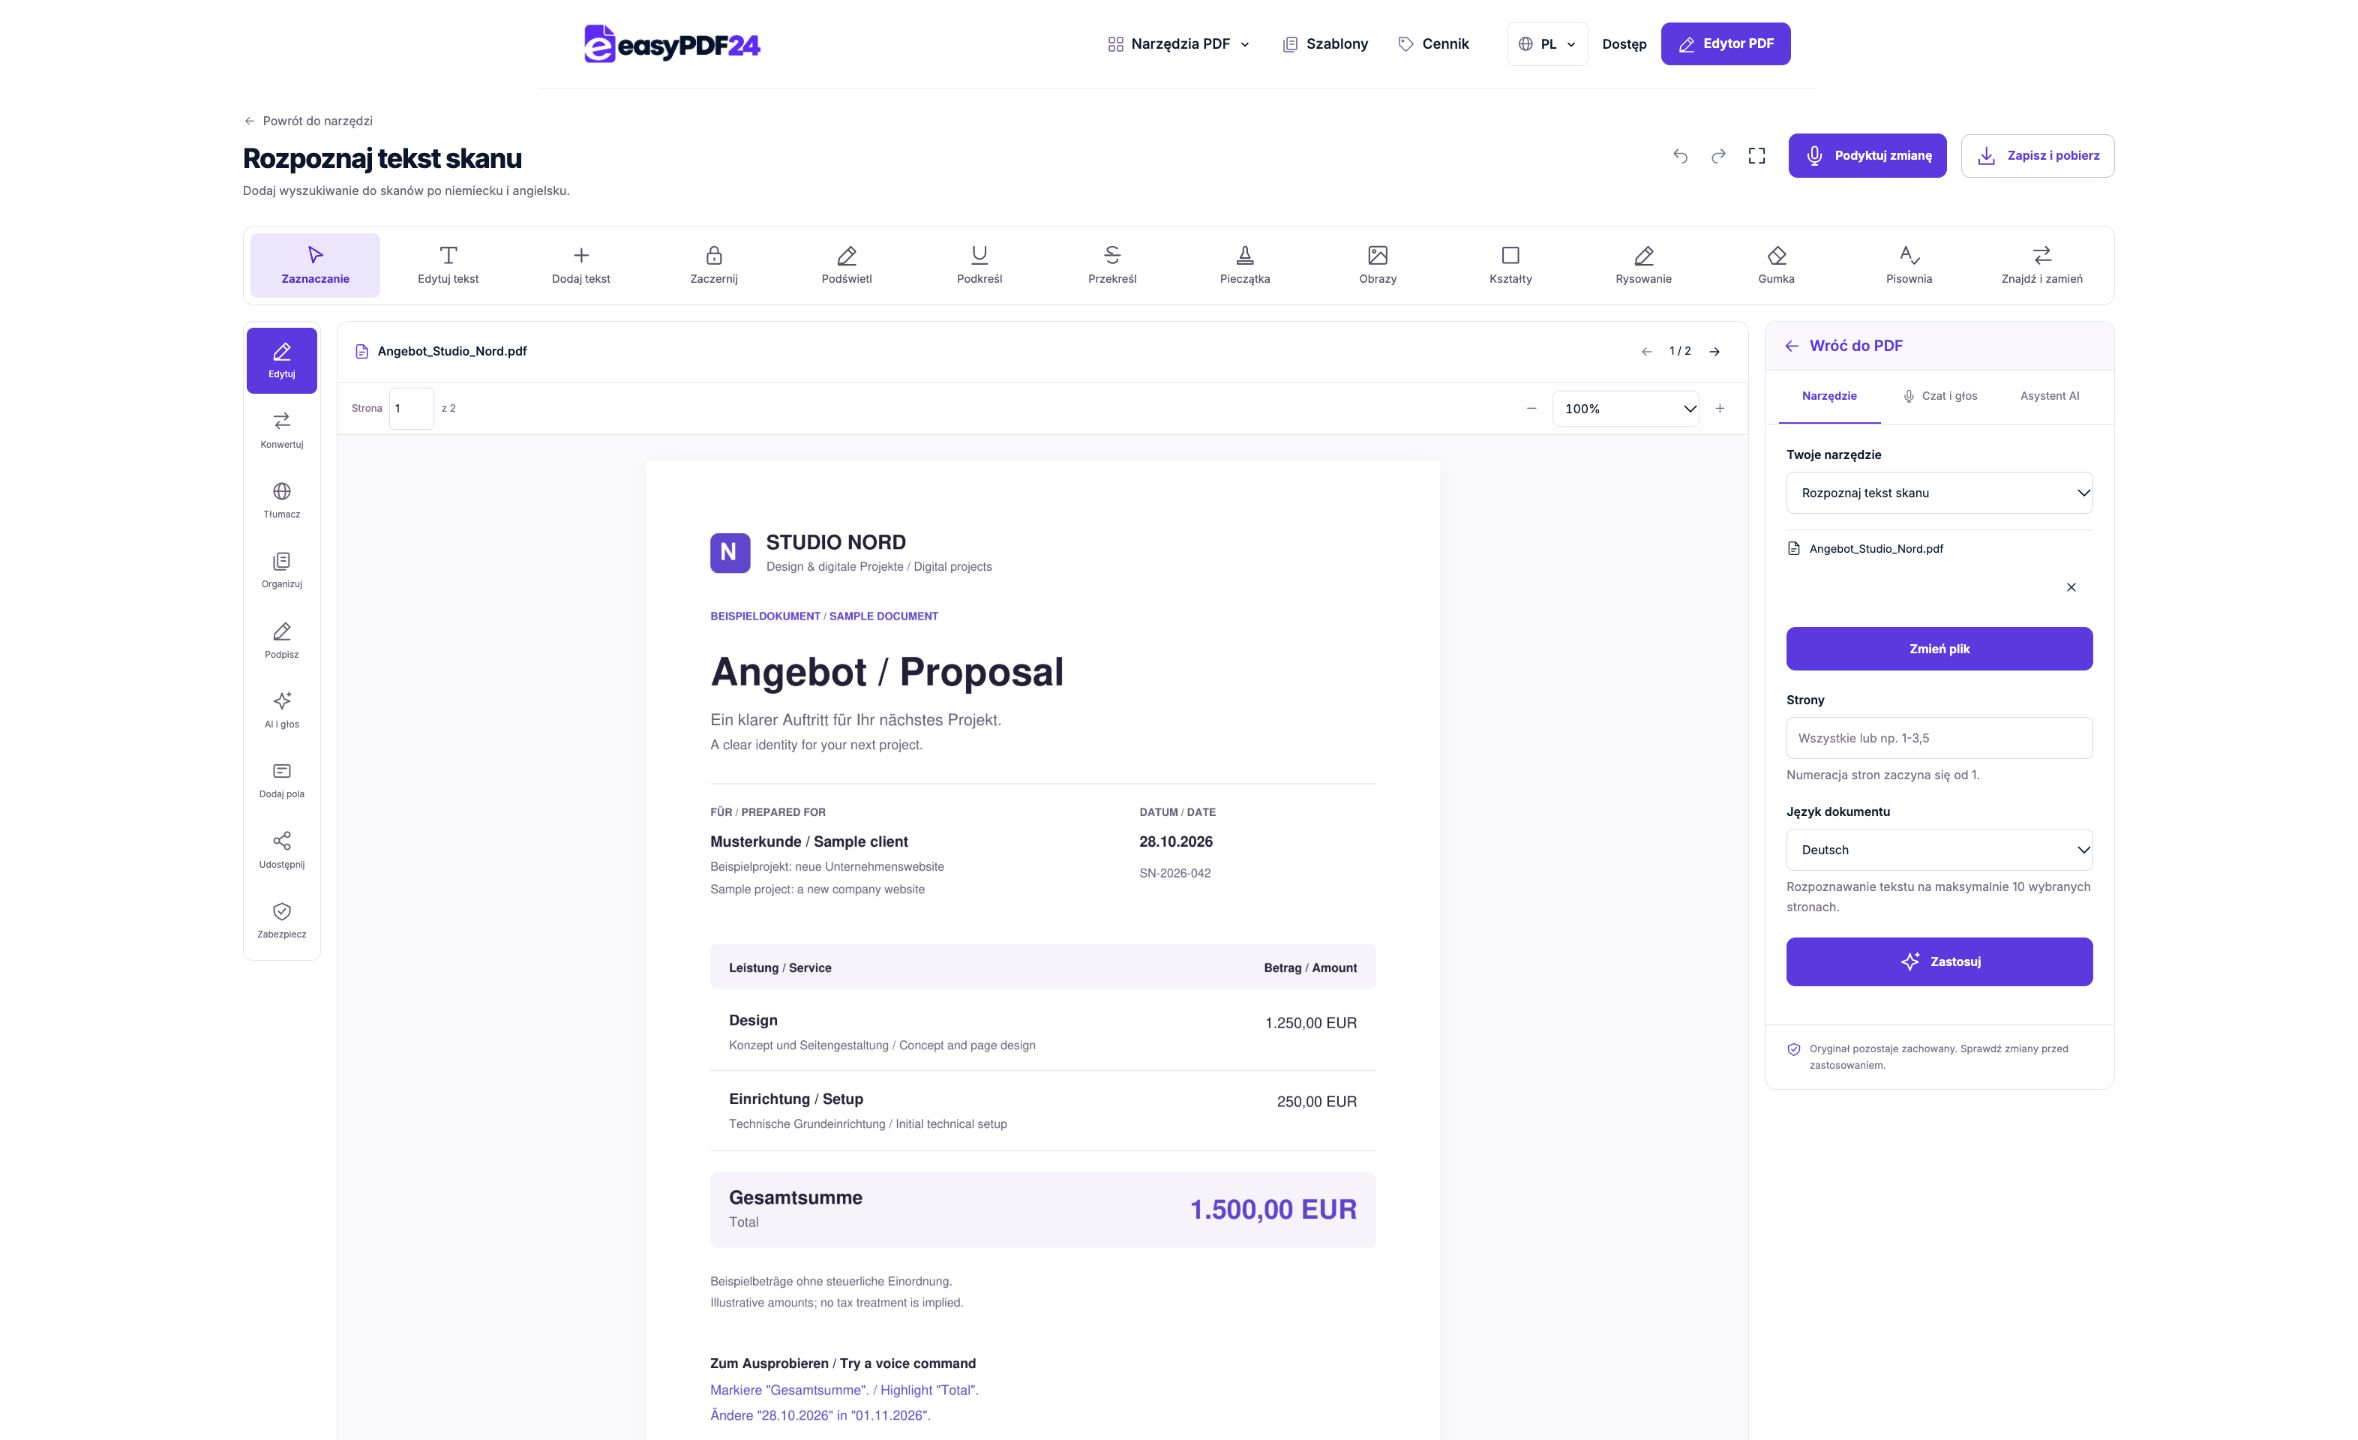
2Ustawienia
Wybierz niemiecki lub angielski jako język rozpoznawania i uruchom OCR.
3Zastosowanie
PDF → PDF
4Przed i po
Wizualna strona → Wyodrębniony tekst
5Sprawdzenie
Porównaj nazwy, liczby i znaki specjalne Sprawdź kolejność czytania i akapity Otwórz ponownie pobrany plik
6Zapis
Wyszukaj znane Ci słowo, które znajduje się na stronie. Sprawdź nazwy, numery i znaki specjalne na widocznym skanie.
Przykład
Przed
Wizualna strona
Po
Wyodrębniony tekst
Sprawdź te elementy wyniku
- Porównaj nazwy, liczby i znaki specjalne
- Sprawdź kolejność czytania i akapity
- Otwórz ponownie pobrany plik
Ustal, czy dokument wymaga OCR
OCR jest przydatny, gdy strona zawiera obraz pisma, a nie użyteczny tekst. Typowym przykładem jest skan wydrukowanego listu. Litery wyglądają na czytelne dla człowieka, ale zwykłe wyszukiwanie może nic nie znaleźć, ponieważ plik PDF przechowuje piksele. OCR próbuje rozpoznać te kształty i dodaje tekst, który przeglądarka plików PDF może wyszukać lub wybrać.
Wypróbuj proste sprawdzenie przed przetworzeniem dokumentu. Wyszukaj charakterystyczne słowo widoczne na stronie i spróbuj wybrać krótkie zdanie. Jeśli oba działają rozsądnie, strona może już zawierać użyteczną warstwę tekstową. Brak znalezienia jednego słowa nie dowodzi, że wszystkie strony są obrazami: pisownia, nietypowe kodowanie lub inny zapisany znak również mogą mieć wpływ na wyszukiwanie. Sprawdź więcej niż jedną lokalizację.
Mieszany plik PDF może zawierać zarówno strony cyfrowe, jak i zeskanowane załączniki. easyPDF24 pomija strony, które już zawierają tekst, zamiast dodawać do nich drugą warstwę. Pomaga to uniknąć powielania tekstu, ale oznacza również, że OCR nie jest ogólnym narzędziem do naprawy istniejącej słabej warstwy tekstowej. Zidentyfikuj, które strony wymagają rozpoznania i sprawdź wynik na tych stronach, zamiast oczekiwać, że każda część pliku zostanie odbudowana.
Przygotuj czytelny skan
Rozpoznawanie zaczyna się od tego, co widoczne. Wyraźne drukowane litery, w miarę prosta strona i spójny kontrast sprawiają, że narzędzie jest lepszym materiałem do pracy. Niewyraźny tekst, cień na liczbie lub zagięty róg mogą pozostawić niejednoznaczność, której oprogramowanie nie będzie w stanie wiarygodnie rozwiązać. Jeśli masz dostęp do papieru lub lepszego skanu źródłowego, poprawa danych wejściowych może być skuteczniejsza niż wielokrotne przetwarzanie tego samego słabego obrazu.
Sprawdź całą stronę, łącznie z drobnym drukiem na krawędziach. Zdjęcie wykonane aparatem może wyglądać ostro w środku, ale tracić szczegóły w pobliżu zakrzywionej oprawy. Stempel może zakryć część słowa, a blada notatka ołówkiem może zniknąć w tle. Zapisz, które obszary wymagają specjalnego sprawdzenia, aby nie zakładać, że udane wyszukiwanie w nagłówku będzie dowodem na to, że stopka została poprawnie rozpoznana.
Użyj narzędzia obrotu, jeśli strona jest zwrócona w złym kierunku. Obrót o ćwierć obrotu różni się od prostowania lekko przekrzywionego obrazu lub korygowania perspektywy aparatu. easyPDF24 nie obiecuje automatycznej naprawy każdego problemu z przechwytywaniem. Przygotuj najjaśniejszy, praktyczny wkład i zachowaj widoczny oryginał do porównania. Dane wyjściowe OCR należy sprawdzić w odniesieniu do tego źródła, zwłaszcza jeśli zamierzasz ponownie wykorzystać nazwiska, daty lub kwoty.
Wybierz obsługiwany język i właściwe strony
Bieżący podgląd OCR obsługuje drukowaną wersję w języku niemieckim i angielskim. Język tego przewodnika, nawigacji lub procesu płatności nie rozszerza języków rozpoznawania. Wybierz język pasujący do zeskanowanego tekstu. W przypadku dokumentu zawierającego kilka języków, jeśli to możliwe, dokonaj odpowiednich selekcji i dokładnie sprawdź fragmenty w różnych językach; nieobsługiwane rozpoznawanie języka nie jest obiecaną funkcją.
Źródłowy plik PDF może zawierać do 80 stron, ale w jednej operacji OCR można uwzględnić nie więcej niż dziesięć wybranych stron. Użyj pola wyboru strony, aby wybrać potrzebne strony, np. 1–5 i 8. Pozycje to rzeczywiste numery stron w pliku PDF, zaczynając od pierwszej strony, a nie numery wydrukowane w dokumencie. Okładka może przesunąć te dwa systemy numeracji.
W przypadku dłuższego źródła przeprowadź kolejny wybór po sprawdzeniu pierwszego wyniku. Śledź, która wersja robocza zawiera dokonane wybory. Małe partie sprawiają również, że recenzowanie jest łatwiejsze: jeśli słaby skan powoduje błędy, odkryjesz to, zanim zaczniesz polegać na pozostałych stronach. Przetwarzanie stron, które są nieistotne dla Twojego zadania, tylko dlatego, że są zawarte w oryginalnym pliku, nie przynosi żadnych korzyści.
Odróżnij obraz strony od warstwy tekstowej
Po rozpoznaniu stronę należy jeszcze sprawdzić wizualnie względem skanu. Tekst, który można przeszukiwać, stanowi dodatkową reprezentację tego, co według narzędzia mówi obraz. Przydaje się do odnalezienia akapitu lub skopiowania fragmentu, ale nie stanowi samodzielnego potwierdzenia, że każdy znak został poprawnie odczytany. Widoczny obraz pozostaje punktem odniesienia przy sprawdzaniu niepewnych odczytów.
To rozróżnienie ma znaczenie w przypadku wrażliwych szczegółów. Wynik wyszukiwania może przeskoczyć w oczekiwane miejsce, gdy skopiowane zdanie zawiera błędną cyfrę. Wiersz tekstu można również rozpoznać w niezręcznej kolejności, gdy rozciąga się na kolumny lub znajduje się obok podpisu. Porównaj zarówno pozycję, jak i faktycznie wyodrębnione znaki. Samo trafienie wyszukiwania mierzy, czy coś zostało znalezione, a nie to, czy cała strona jest dokładna.
OCR nie przekształca automatycznie złożonego zeskanowanego układu w w pełni edytowalny dokument źródłowy. Nie odtwarza każdej komórki tabeli, nie odtwarza oryginalnego zbioru czcionek ani nie zapewnia gwarantowanej kolejności czytania w przypadku skomplikowanych projektów stron. Jeśli Twoim następnym zadaniem będzie znaczne przepisanie tekstu, użyj rozpoznanego tekstu jako materiału do przejrzanego i sformatowanego dokumentu. Podczas wykonywania tej pracy przechowuj plik PDF pod ręką, aby referencje były łatwe do zweryfikowania.
Prześledź przykład rozpoznawania tekstu
Wyobraź sobie ośmiostronicowy zeskanowany raport w języku angielskim. Musisz zlokalizować trzy odniesienia do projektu i skopiować krótki akapit ze strony 6. Najpierw sprawdź, czy odniesienia i akapit są czytelne na obrazach. Przeszukaj istniejący plik PDF; jeśli wymagane strony nie zawierają użytecznego tekstu, wybierz te strony do OCR, zamiast zakładać, że każda strona wymaga przetworzenia.
Uruchom rozpoznawanie z wybranym językiem angielskim. W rezultacie wyszukaj jedno odniesienie do projektu dokładnie tak, jak zostało wydrukowane, a następnie sprawdź odpowiednią stronę. Skopiuj akapit do tymczasowego pola tekstowego i porównaj go linia po linii ze skanem. Sprawdź interpunkcję wokół dat, kolejność klauzul i kod odniesienia. Kod taki jak litera, po której następuje kilka cyfr, wymaga indywidualnej uwagi, ponieważ wiarygodnie wyglądający błąd może być łatwy do przeoczenia.
Jeśli akapit przekracza granicę strony, sprawdź obie strony tej granicy. Brakujący ostatni wiersz może zmienić znaczenie, nawet jeśli główny akapit wygląda poprawnie. Zapisz rozpoznany plik PDF, gdy spełni on zadanie, i zachowaj osobną notatkę dotyczącą wszelkich poprawionych znaków w ponownie użytym tekście. Ułatwia to prześledzenie późniejszego dokumentu do widocznego źródła bez udawania, że OCR zweryfikował treść za Ciebie.
Sprawdź liczby, nazwiska i kolejność tekstu
Nadaj priorytet treściom, w których mały błąd ma duży wpływ. Nazwy, identyfikatory referencyjne, ilości, wartości procentowe, daty i separatory dziesiętne należy sprawdzać znak po znaku, jeśli mają one znaczenie dla następnego działania. Podobne kształty, takie jak zero i litera O lub jedynka i mała litera l, są częstymi źródłami niejednoznaczności w skanach o niskiej jakości. Prawidłowy odczyt wynika z kontekstu źródłowego i obrazu, a nie z płynności dźwięku wyjściowego.
W przypadku tabel sprawdź jeden pełny wiersz we wszystkich kolumnach. Wyodrębnianie tekstu może umieścić wartość obok niewłaściwego nagłówka, nawet jeśli rozpoznano każdą pojedynczą liczbę. Nie wnioskuj o zrekonstruowanym arkuszu kalkulacyjnym na podstawie wyglądu tekstu tabelarycznego. Jeśli potrzebujesz obliczeń, przebuduj i zweryfikuj tabelę w odpowiedniej aplikacji, zamiast traktować eksport w postaci zwykłego tekstu jako wiarygodną strukturę danych.
W przypadku kolumn i przypisów przeczytaj skopiowany fragment od początku do końca. Zanim przejdziesz do następnej kolumny, sprawdź, czy tekst podąża za zamierzoną kolumną i czy w środku zdania nie wstawiono przypisu. Są to raczej problemy z kolejnością czytania niż zwykłe błędy ortograficzne. Wymagają przeczytania i sprawdzenia całego fragmentu, a nie tylko wyszukania nietypowych znaków.
Wybierz dalszy krok po OCR
Jeśli potrzebujesz jedynie zlokalizować informacje w pliku PDF, wystarczy sprawdzona wersja z możliwością wyszukiwania. Możesz wyszukiwać charakterystyczne terminy i czytać oryginalną stronę przy każdym wyniku. Unikaj konwersji na inny format bez powodu, ponieważ każda dodatkowa reprezentacja wprowadza kolejny wynik do sprawdzenia. Plik PDF z przydatnym wyszukiwaniem może już rozwiązać zadanie archiwizacyjne lub referencyjne.
Jeśli potrzebujesz tekstu do ponownego wykorzystania, narzędzie PDF do Word eksportuje obsługiwany tekst do wyboru do prostego dokumentu DOCX. Nie obiecuje odtworzenia oryginalnego układu strony, tabel ani obrazów. Otwórz plik DOCX w kompatybilnym edytorze, uporządkuj nagłówki i akapity, a następnie porównaj ważne fragmenty z rozpoznanym plikiem PDF. Rozpoznawanie i formatowanie dokumentu to osobne etapy, każdy podlega odrębnej kontroli.
W przypadku małej korekty przejrzyj operacje tekstowe obsługiwane przez edytor, ale nie zakładaj, że każde widoczne słowo na obrazie można teraz swobodnie edytować. Zeskanowany wygląd i zachowanie warstwy tekstowej mogą się różnić. Jeśli sam obraz wymaga zmiany, użyj odpowiedniego obszaru lub operacji na obrazie i sprawdź efekt wizualny. OCR to sposób na przeszukiwanie tekstu, a nie uniwersalny substytut każdego rodzaju edycji plików PDF.
Rozwiąż problemy z pustym lub niedokładnym wynikiem
Jeżeli po rozpoznaniu nie uzyskano zbyt wiele przydatnego tekstu, najpierw sprawdź źródło przy większym powiększeniu. Czy wydruk jest rzeczywiście wystarczająco ostry, aby można go było odczytać? Czy wybrany język jest obsługiwany? Czy na stronie znajduje się pismo odręczne, nietypowe litery lub gęsta tabela, a nie zwykłe drukowane akapity? Pytania te pomagają określić, czy dane wejściowe są odpowiednie, zanim powtórzysz tę samą operację z identycznymi ustawieniami.
Jeśli strona zawiera już tekst, można go pominąć. To może wyjaśniać, dlaczego OCR nie poprawia wcześniej rozpoznanej, ale niedokładnej warstwy. Sprawdź wynik zaznaczenia i skopiowania tekstu z oryginalnej strony. Mały element tekstowy może również sprawić, że strona będzie inna niż skan składający się wyłącznie z obrazu. Kolejne rozpoznawanie OCR nie musi zastąpić istniejącej warstwy tekstowej.
Jeśli tylko niektóre strony są błędne, odizoluj je do sprawdzenia, zamiast odrzucać przydatne wyniki gdzie indziej. Sprawdź ponownie swój wybór względem licznika stron redaktora, a następnie porównaj oczekiwane strony w wynikach. W przypadku obszarów stale nieczytelnych należy uzyskać lepszy skan, jeśli to możliwe. Ręczna weryfikacja krótkiego niezbędnego fragmentu może być bardziej niezawodna niż użycie długiej, niesprawdzonej transkrypcji po prostu dlatego, że została wygenerowana automatycznie.
Oddziel poprawki od materiału źródłowego
Kiedy OCR wspiera badania, administrację lub przygotowanie dokumentów, oddziel to, co w widoczny sposób mówi źródło, od wszelkich sformułowań, które później poprawisz lub przepiszesz. Rozpoznany tekst może zawierać błąd odczytu maszynowego, natomiast samo źródło może zawierać oryginalną literówkę. Naprawienie tych dwóch rzeczy służy różnym celom. Zachowaj wystarczający kontekst, aby zrozumieć, czy nowe sformułowanie jest wierną transkrypcją, czy korektą redakcyjną.
Używaj wyraźnych nazw plików dla skanu źródłowego, kopii z możliwością przeszukiwania i każdej późniejszej wersji roboczej programu Word. Nie potrzebujesz skomplikowanego systemu archiwizacji, aby uniknąć zamieszania; wystarczający może być spójny opisowy przyrostek i data. Liczy się możliwość zidentyfikowania, który plik zawiera obraz źródłowy, a który zawiera późniejsze zmiany. Nie zastępuj jedynej kopii oryginału niesprawdzonym eksportem.
Zapisz wynik, który chcesz zachować na swoim urządzeniu. OCR nie jest usługą stałego przechowywania. Jeśli dokument zawiera informacje, które nie powinny być przesyłane do tego podglądu, wybierz odpowiedni alternatywny przepływ pracy przed jego przetworzeniem, zamiast traktować rozpoznanie jako coś, co koniecznie dzieje się tylko w Twojej przeglądarce.
Sprawdź wynik zgodnie z jego przeznaczeniem
Przydatna kontrola końcowa opiera się na tym, co planujesz zrobić z wynikami. Aby wyszukać, przetestuj kilka charakterystycznych słów na różnych przetworzonych stronach. Aby skopiować, porównaj pełny akapit i trudną linię zawierającą liczby. W celu późniejszej konwersji otwórz również ten przekonwertowany plik i sprawdź kolejność i kompletność jego zawartości. Każdy sprawdzian odpowiada na inne pytanie praktyczne.
Nie używaj jednego udanego wyszukiwania słów jako wyniku jakości całego dokumentu. Wyraźny tytuł może być łatwy do rozpoznania, podczas gdy małe przypisy pozostają niedokładne. Wypróbuj różne części strony, a następnie sprawdź wszystkie szczegóły, od których zależy Twoje zadanie. Tam, gdzie istotna jest dokładność, niezbędny przegląd może być szerszy niż szybka próbka; narzędzie nie może zdecydować, który błędny znak będzie dla Ciebie najważniejszy.
Gdy wybrane strony będą zadowalające, pobierz plik PDF z możliwością przeszukiwania w ramach dostępnej procedury realizacji transakcji i ponownie otwórz zapisany plik. Upewnij się, że wyszukiwanie działa w przeglądarce, której będziesz używać dalej. Masz wtedy sprawdzony dokument roboczy w określonym celu, a nie niezweryfikowany zapis, którego sam wygląd sugeruje, że musi być poprawny.
Pytania i odpowiedzi
Jakie języki obsługuje to narzędzie OCR?
Bieżąca wersja zapoznawcza obsługuje język niemiecki i angielski. Przewodnik napisany w innym języku nie oznacza, że OCR obsługuje ten język.
Czy mogę przetworzyć dokument dłuższy niż 10 stron?
Tak, w ramach limitu 80 stron dokumentu. Wybierz nie więcej niż 10 stron na operację OCR, a następnie w razie potrzeby przeprowadź kolejny wybór.