
In deze gids
Zo werkt het
Open een leesbare gescande PDF. Selecteer maximaal 10 pagina's voor deze OCR-bewerking; de bron-PDF kan maximaal 80 pagina's bevatten.
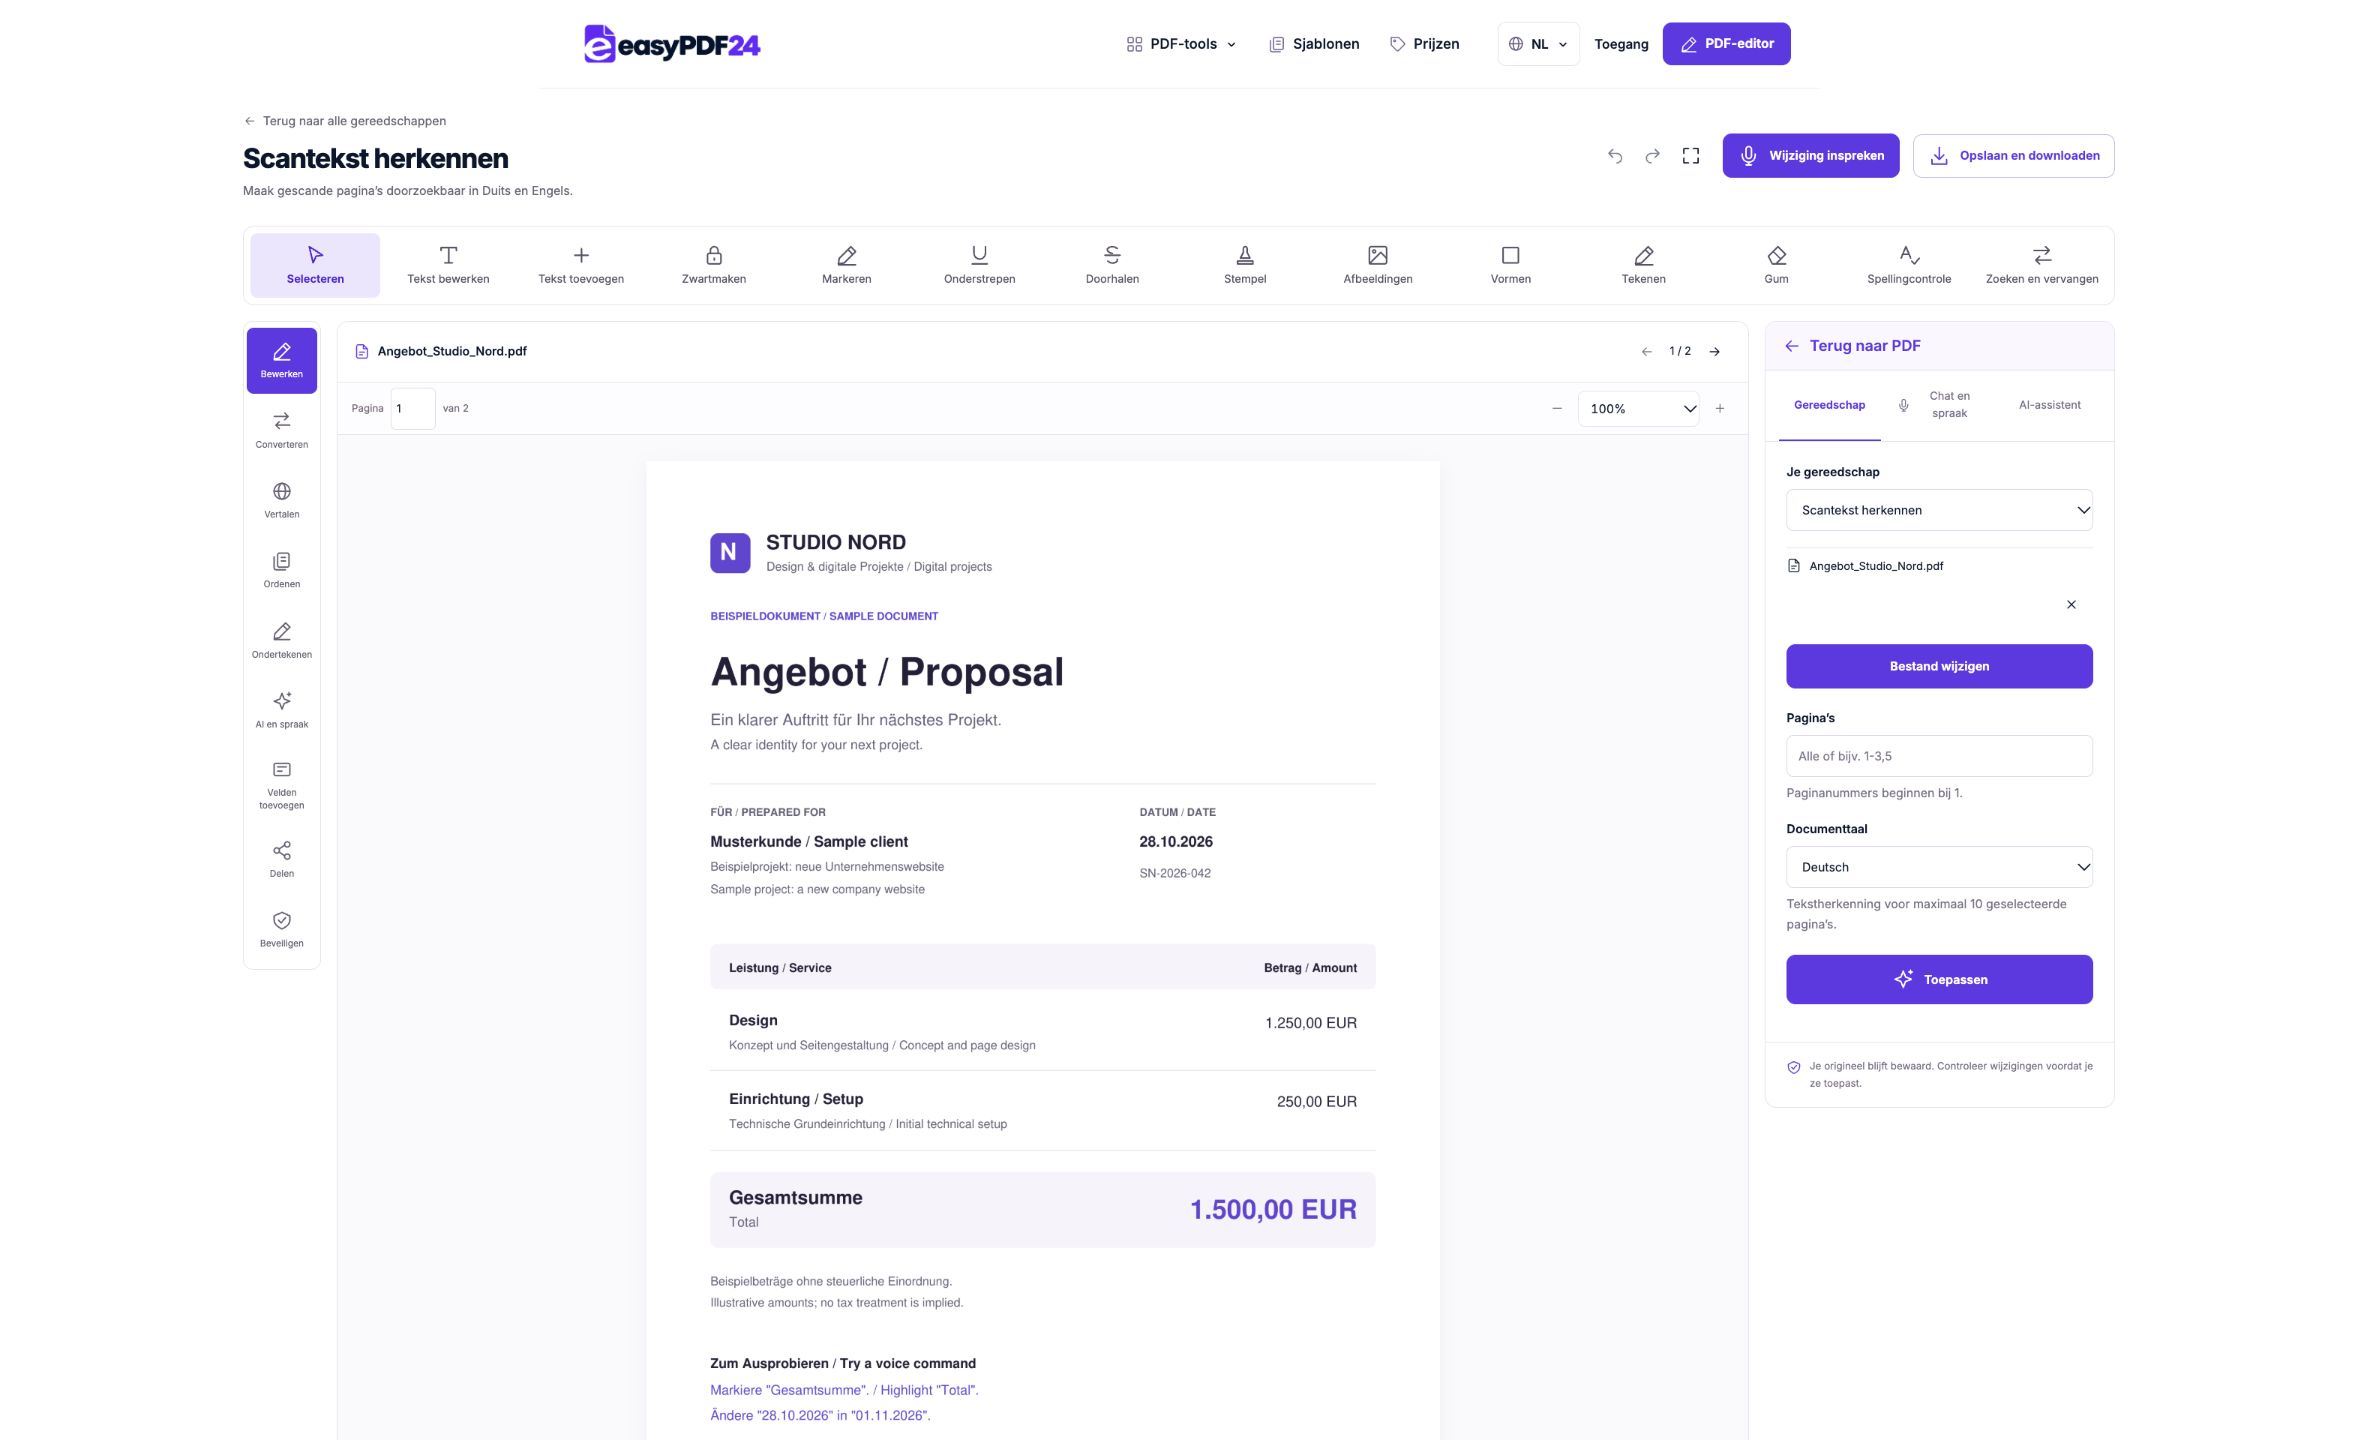
Kies Duits of Engels als herkenningstaal en voer OCR uit.
Zoek naar een woord waarvan je weet dat het op de pagina staat. Controleer namen, cijfers en speciale tekens aan de hand van de zichtbare scan.
Invoer, resultaat en grenzen
| Eigenschap | Details |
|---|---|
| Invoer | |
| Uitvoer | |
| Belangrijke beperking | Duitse of Engelse OCR; maximaal 10 geselecteerde pagina’s. |
De werkwijze in zes beelden
1Invoer
Open een leesbare gescande PDF. Selecteer maximaal 10 pagina's voor deze OCR-bewerking; de bron-PDF kan maximaal 80 pagina's bevatten.
2Instellingen
Kies Duits of Engels als herkenningstaal en voer OCR uit.
3Toepassen
PDF → PDF
4Voor en na
Visuele pagina → Uitgelezen tekst
5Controleren
Vergelijk namen, getallen en bijzondere tekens Controleer leesvolgorde en alinea’s Open het gedownloade bestand opnieuw
6Opslaan
Zoek naar een woord waarvan je weet dat het op de pagina staat. Controleer namen, cijfers en speciale tekens aan de hand van de zichtbare scan.
Voorbeeld
Voor
Visuele pagina
Na
Uitgelezen tekst
Controleer deze punten in het resultaat
- Vergelijk namen, getallen en bijzondere tekens
- Controleer leesvolgorde en alinea’s
- Open het gedownloade bestand opnieuw
Bepaal of de PDF tekstherkenning nodig heeft
OCR is handig wanneer een pagina een geschreven afbeelding bevat in plaats van bruikbare tekst. Een scan van een gedrukte brief is een bekend voorbeeld. De letters zien er voor een persoon leesbaar uit, maar gewone zoekopdrachten kunnen niets opleveren omdat de PDF pixels bevat. OCR probeert deze vormen te herkennen en voegt tekst toe die een PDF-viewer kan doorzoeken of selecteren.
Probeer een eenvoudige controle voordat je het document verwerkt. Zoek naar een onderscheidend woord dat zichtbaar is op de pagina en probeer een korte zin te selecteren. Als beide verstandig werken, bevat de pagina mogelijk al een bruikbare tekstlaag. Het niet vinden van één woord bewijst niet dat alle pagina's afbeeldingen zijn: spelling, ongebruikelijke codering of een ander opgeslagen teken kunnen ook van invloed zijn op een zoekopdracht. Inspecteer meer dan één locatie.
Een gemengde PDF kan zowel digitale pagina's als gescande bijlagen bevatten. easyPDF24 slaat pagina's over die al tekst bevatten in plaats van er een tweede laag aan toe te voegen. Dit helpt dubbele tekst te voorkomen, maar het betekent ook dat OCR geen algemeen reparatiehulpmiddel is voor een bestaande slechte tekstlaag. Identificeer welke pagina's moeten worden herkend en controleer het resultaat op die pagina's in plaats van te verwachten dat elk deel van het bestand opnieuw wordt opgebouwd.
Bereid een leesbare scan voor voordat je OCR uitvoert
Herkenning begint bij wat zichtbaar is. Duidelijke gedrukte letters, een redelijk rechte pagina en consistent contrast geven het gereedschap beter materiaal om mee te werken. Wazige tekst, een schaduw over een getal of een gevouwen hoek kunnen onduidelijkheden achterlaten die software niet op betrouwbare wijze kan oplossen. Als je toegang hebt tot het papier of een betere bronscan, kan het verbeteren van de invoer effectiever zijn dan het herhaaldelijk verwerken van hetzelfde slechte beeld.
Controleer de hele pagina, inclusief kleine lettertjes aan de randen. Een camerafoto kan er in het midden scherp uitzien, maar verliest details bij een gebogen paginabinding. Een stempel kan een deel van een woord bedekken en een bleke potloodaantekening kan naar de achtergrond verdwijnen. Registreer welke gebieden speciaal moeten worden gecontroleerd, zodat je er niet van uitgaat dat een succesvolle zoekactie in de kop bewijst dat de voettekst correct is herkend.
Gebruik het rotatiegereedschap als een pagina de verkeerde kant op kijkt. Een kwartslag draaien is iets anders dan het rechttrekken van een enigszins scheef beeld of het corrigeren van het cameraperspectief. easyPDF24 belooft niet elk opnameprobleem automatisch te herstellen. Bereid de duidelijkste praktische input voor en bewaar het zichtbare origineel ter vergelijking. De OCR-uitvoer moet worden gecontroleerd aan de hand van die bron, vooral als je van plan bent namen, datums of bedragen opnieuw te gebruiken.
Kies de ondersteunde taal en paginaselectie
Het huidige OCR-voorbeeld ondersteunt gedrukt Duits en Engels. De taal van deze gids, de navigatie of het afrekenen breidt de herkenningstalen niet uit. Kies de taal die overeenkomt met de gescande tekst. Voor een document dat meerdere talen bevat, moet je waar mogelijk met de juiste selecties werken en passages in gemengde talen zorgvuldig inspecteren; niet-ondersteunde taalherkenning is geen beloofde functie.
Een bron-PDF kan maximaal 80 pagina's bevatten, maar één OCR-bewerking accepteert niet meer dan tien geselecteerde pagina's. Gebruik het paginaselectieveld om de gewenste pagina's te kiezen, zoals 1–5 en 8. De posities zijn de daadwerkelijke paginanummers in de PDF, te beginnen met de eerste pagina, in plaats van de nummers die in het document zijn afgedrukt. Een omslag kan deze twee nummeringssystemen verschuiven.
Voor een langere bron verwerk je nog een selectie nadat je het eerste resultaat hebt gecontroleerd. Houd bij welke werkende versie de voltooide selecties bevat. Kleine batches maken de beoordeling ook beter beheersbaar: als een slechte scan fouten oplevert, ontdekt je dat voordat je op de resterende pagina's vertrouwt. Er zijn geen voordelen verbonden aan het verwerken van pagina's die niet relevant zijn voor je taak, alleen maar omdat ze in het originele bestand zijn opgenomen.
Begrijp de zichtbare pagina en de tekstlaag ervan
Na herkenning dient de pagina alsnog visueel te worden gecontroleerd aan de hand van de scan. De doorzoekbare tekst is een aanvullende weergave van wat de tool denkt dat de afbeelding zegt. Het is handig voor het vinden van een alinea of het kopiëren van een passage, maar het is geen onafhankelijke bevestiging dat elk teken correct is gelezen. Het zichtbare beeld blijft je referentie voor het controleren van onzekere herkenningsresultaten.
Dit onderscheid is van belang voor gevoelige details. Een zoekresultaat kan naar de verwachte plaats springen terwijl de gekopieerde zin een verkeerd cijfer bevat. Een regel tekst kan ook in een lastige volgorde worden herkend als deze kolommen overspant of naast een bijschrift staat. Vergelijk zowel de positie als de daadwerkelijk geëxtraheerde tekens. Alleen een zoekhit meet of er iets is gevonden, niet of de hele pagina klopt.
OCR verandert een complexe gescande lay-out niet automatisch in een volledig bewerkbaar brondocument. Het herbouwt niet elke tabelcel, herschept niet de originele lettertypecollectie of biedt een gegarandeerde leesvolgorde voor ingewikkelde paginaontwerpen. Als je volgende taak substantieel herschrijven is, gebruik dan de herkende tekst als materiaal voor een document dat je beoordeelt en opmaakt. Houd de PDF beschikbaar terwijl je dat werk doet, zodat referenties gemakkelijk te verifiëren blijven.
Werk een praktisch herkenningsvoorbeeld door
Stel je een gescand rapport van acht pagina's voor in het Engels. Je moet drie projectreferenties zoeken en een korte paragraaf van pagina 6 kopiëren. Controleer eerst of de verwijzingen en de paragraaf leesbaar zijn in de afbeeldingen. Doorzoek de bestaande PDF; Als de vereiste pagina's geen bruikbare tekst bevatten, selecteer je die pagina's voor OCR in plaats van ervan uit te gaan dat elke pagina moet worden verwerkt.
Voer herkenning uit met Engels geselecteerd. Zoek in het resultaat één projectreferentie precies zoals afgedrukt en inspecteer vervolgens de bijbehorende pagina. Kopieer de alinea naar een tijdelijk tekstveld en vergelijk deze regel voor regel met de scan. Controleer de interpunctie rond datums, de volgorde van de clausules en eventuele referentiecodes. Een code zoals een letter gevolgd door meerdere cijfers verdient individuele aandacht, omdat een plausibel ogende fout gemakkelijk over het hoofd kan worden gezien.
Als de alinea een paginagrens overschrijdt, inspecteer dan beide zijden van die grens. Een ontbrekende laatste regel kan de betekenis veranderen, zelfs als de hoofdparagraaf er correct uitziet. Sla de herkende PDF op wanneer deze aan de taak voldoet, en noteer alle tekens die je in hergebruikte tekst hebt gecorrigeerd. Dat maakt het gemakkelijker om je latere document te herleiden naar de zichtbare bron, zonder te doen alsof OCR de inhoud voor je hebt geverifieerd.
Bekijk nummers, namen en leesvolgorde
Geef prioriteit aan de inhoud waarbij een kleine fout een groot effect heeft. Namen, referentie-identificatoren, hoeveelheden, percentages, datums en decimale scheidingstekens moeten karakter voor karakter worden gecontroleerd wanneer ze van belang zijn voor de volgende actie. Soortgelijke vormen zoals nul en de letter O, of één en een kleine letter l, zijn veelvoorkomende bronnen van dubbelzinnigheid in scans van lage kwaliteit. De juiste lezing komt van de broncontext en het beeld, niet van hoe vloeiend de uitvoer klinkt.
Inspecteer voor tabellen één volledige rij over alle kolommen. Tekstextractie kan een waarde naast de verkeerde kop plaatsen, zelfs als elk afzonderlijk nummer werd herkend. Leid een gereconstrueerd spreadsheet niet af uit het uiterlijk van tekst in tabelvorm. Als je berekeningen nodig hebt, moet je de tabel opnieuw opbouwen en verifiëren in een geschikte toepassing, in plaats van een export van platte tekst als een betrouwbare gegevensstructuur te behandelen.
Voor kolommen en voetnoten lees je de gekopieerde passage van begin tot eind. Controleer of de tekst de beoogde kolom volgt voordat je naar de volgende gaat en of er midden in een zin een voetnoot is ingevoegd. Dit zijn leesvolgordeproblemen en geen eenvoudige spelfouten. Ze vereisen een redactionele beoordeling van de passage, niet alleen een zoektocht naar ongebruikelijke tekens.
Kies de juiste volgende stap na OCR
Als je alleen informatie in de PDF hoeft te vinden, kan een gecontroleerde doorzoekbare versie voldoende zijn. Je kunt zoeken naar onderscheidende termen en bij elk resultaat de originele pagina lezen. Vermijd om zonder reden naar een ander formaat te converteren, omdat elke extra representatie een ander resultaat introduceert om te beoordelen. Een PDF met handige zoekfunctie kan een archief- of referentietaak al oplossen.
Als je herbruikbare tekst nodig hebt, exporteert de PDF-naar-Word-tool ondersteunde selecteerbare tekst naar een eenvoudig DOCX-document. Het belooft niet de originele pagina-indeling, tabellen of afbeeldingen te reproduceren. Open de DOCX in een compatibele editor, orden koppen en alinea's en vergelijk vervolgens belangrijke passages met de herkende PDF. Herkenning en documentopmaak zijn afzonderlijke fasen, elk met hun eigen controles.
Onderzoek voor een kleine correctie de door de editor ondersteunde tekstbewerkingen, maar ga er niet vanuit dat elk zichtbaar woord in een afbeelding nu vrijelijk op zijn plaats kan worden bewerkt. Het gescande uiterlijk en het gedrag van de tekstlaag kunnen verschillen. Wanneer een afbeelding zelf moet worden gewijzigd, gebruik dan een geschikt gebied of beeldbewerking en inspecteer het visuele resultaat. OCR is een route naar doorzoekbare tekst, en geen universele vervanging voor elke vorm van PDF-bewerking.
Problemen met een leeg of teleurstellend resultaat oplossen
Als herkenning weinig bruikbare tekst oplevert, bekijk dan eerst de bron met een grotere zoomlens. Is de afdruk eigenlijk scherp genoeg om te lezen? Wordt de gekozen taal ondersteund? Bevat de pagina handschrift, ongebruikelijke letters of een dichte tabel in plaats van gewone gedrukte alinea's? Deze vragen helpen bepalen of de ingang geschikt is voordat je dezelfde handeling herhaalt met identieke instellingen.
Als een pagina al tekst bevat, kan deze worden overgeslagen. Dat kan verklaren waarom OCR een eerder herkende maar onnauwkeurige laag niet verbetert. Controleer het resultaat van het selecteren en kopiëren van tekst van de originele pagina. Een klein tekstelement kan een pagina ook anders maken dan een scan die uitsluitend uit afbeeldingen bestaat. Beloof niet dat een nieuwe herkenningspas elke bestaande tekstrepresentatie zal vervangen.
Als slechts enkele pagina's onjuist zijn, isoleer die pagina's dan ter beoordeling in plaats van een nuttig resultaat elders weg te gooien. Controleer je selectie opnieuw met de paginateller van de editor en vergelijk vervolgens de verwachte pagina's in de uitvoer. Voor voortdurend onleesbare gebieden probeer je indien mogelijk een betere scan te verkrijgen. Handmatige verificatie van een korte noodzakelijke passage kan betrouwbaarder zijn dan het gebruik van een lange, ongecontroleerde transcriptie, simpelweg omdat deze automatisch is gegenereerd.
Houd correcties en bronmateriaal onderscheidend
Wanneer OCR onderzoek, administratie of documentvoorbereiding ondersteunt, scheid dan wat de bron zichtbaar zegt van de bewoordingen die je later corrigeert of herschrijft. De herkende tekst kan een leesfout bevatten, terwijl de bron zelf mogelijk een originele typefout bevat. Het oplossen van deze twee dingen dient verschillende doeleinden. Zorg voor voldoende context om te begrijpen of je nieuwe bewoording een getrouwe transcriptie of een redactionele herziening is.
Gebruik duidelijke bestandsnamen voor de bronscan, de doorzoekbare kopie en eventuele latere Word-versie. Je hebt geen ingewikkeld archiefsysteem nodig om verwarring te voorkomen; een consistent beschrijvend achtervoegsel en datum kunnen voldoende zijn. Waar het om gaat, is dat je kunt identificeren welk bestand de bronafbeelding bevat en welk bestand je daaropvolgende wijzigingen bevat. Vervang je enige kopie van het origineel niet door een ongecontroleerde export.
Bewaar een resultaat dat je wilt bewaren op je eigen apparaat. OCR is geen permanente opslagservice. Als het document informatie bevat die niet naar dit voorbeeld moet worden geüpload, kies dan een geschikte alternatieve workflow voordat je het verwerkt, in plaats van de herkenning te behandelen als iets dat noodzakelijkerwijs alleen in je browser gebeurt.
Controleer het document voor het beoogde gebruik
Een nuttige laatste controle is gebaseerd op wat je met de uitvoer wilt doen. Test voor het zoeken verschillende onderscheidende woorden op verschillende verwerkte pagina's. Vergelijk voor het kopiëren een volledige alinea en een moeilijke regel met cijfers. Voor een latere conversie open je ook dat geconverteerde bestand en inspecteer je de volgorde en volledigheid van de inhoud. Elke cheque beantwoordt een andere praktijkvraag.
Gebruik niet één succesvolle woordzoeker als kwaliteitsscore voor een heel document. Een duidelijke titel kan gemakkelijk te herkennen zijn, terwijl kleine voetnoten onnauwkeurig blijven. Bekijk verschillende delen van de pagina en inspecteer vervolgens alle details waarvan je taak afhankelijk is. Wanneer nauwkeurigheid essentieel is, kan de noodzakelijke beoordeling uitgebreider zijn dan een snelle steekproef; de tool kan niet beslissen welk verkeerd karakter voor jou het belangrijkst is.
Zodra de geselecteerde pagina's bevredigend zijn, download je de doorzoekbare PDF via de beschikbare betaalstroom en open je het opgeslagen bestand opnieuw. Controleer of de zoekopdracht werkt in de viewer die je hierna gaat gebruiken. Je beschikt dan over een gecontroleerd werkdocument voor een bepaald doel, in plaats van een niet-geverifieerd transcript waarvan het uiterlijk alleen al suggereert dat het correct moet zijn.
Veelgestelde vragen
Welke talen ondersteunt deze OCR-tool?
easyPDF24 ondersteunt Duits en Engels. Een handleiding geschreven in een andere taal betekent niet dat OCR die taal ondersteunt.
Kan ik een document langer dan 10 pagina's verwerken?
Ja, binnen de documentlimiet van 80 pagina's. Kies niet meer dan 10 pagina's per OCR-bewerking en verwerk indien nodig een andere selectie.