
In deze gids
Zo werkt het
Open een PDF waarvan de tekst kan worden uitgelezen.
Kies de HTML-export en laat het tekstbestand maken.
Open het resultaat en controleer de leesvolgorde, tekens en paginakoppen.
Invoer, resultaat en grenzen
| Eigenschap | Details |
|---|---|
| Invoer | |
| Uitvoer | HTML |
| Belangrijke beperking | Tekstuitvoer zonder reconstructie van afbeeldingen, tabellen of paginaopmaak. |
De werkwijze in zes beelden
1Invoer
Open een PDF waarvan de tekst kan worden uitgelezen.
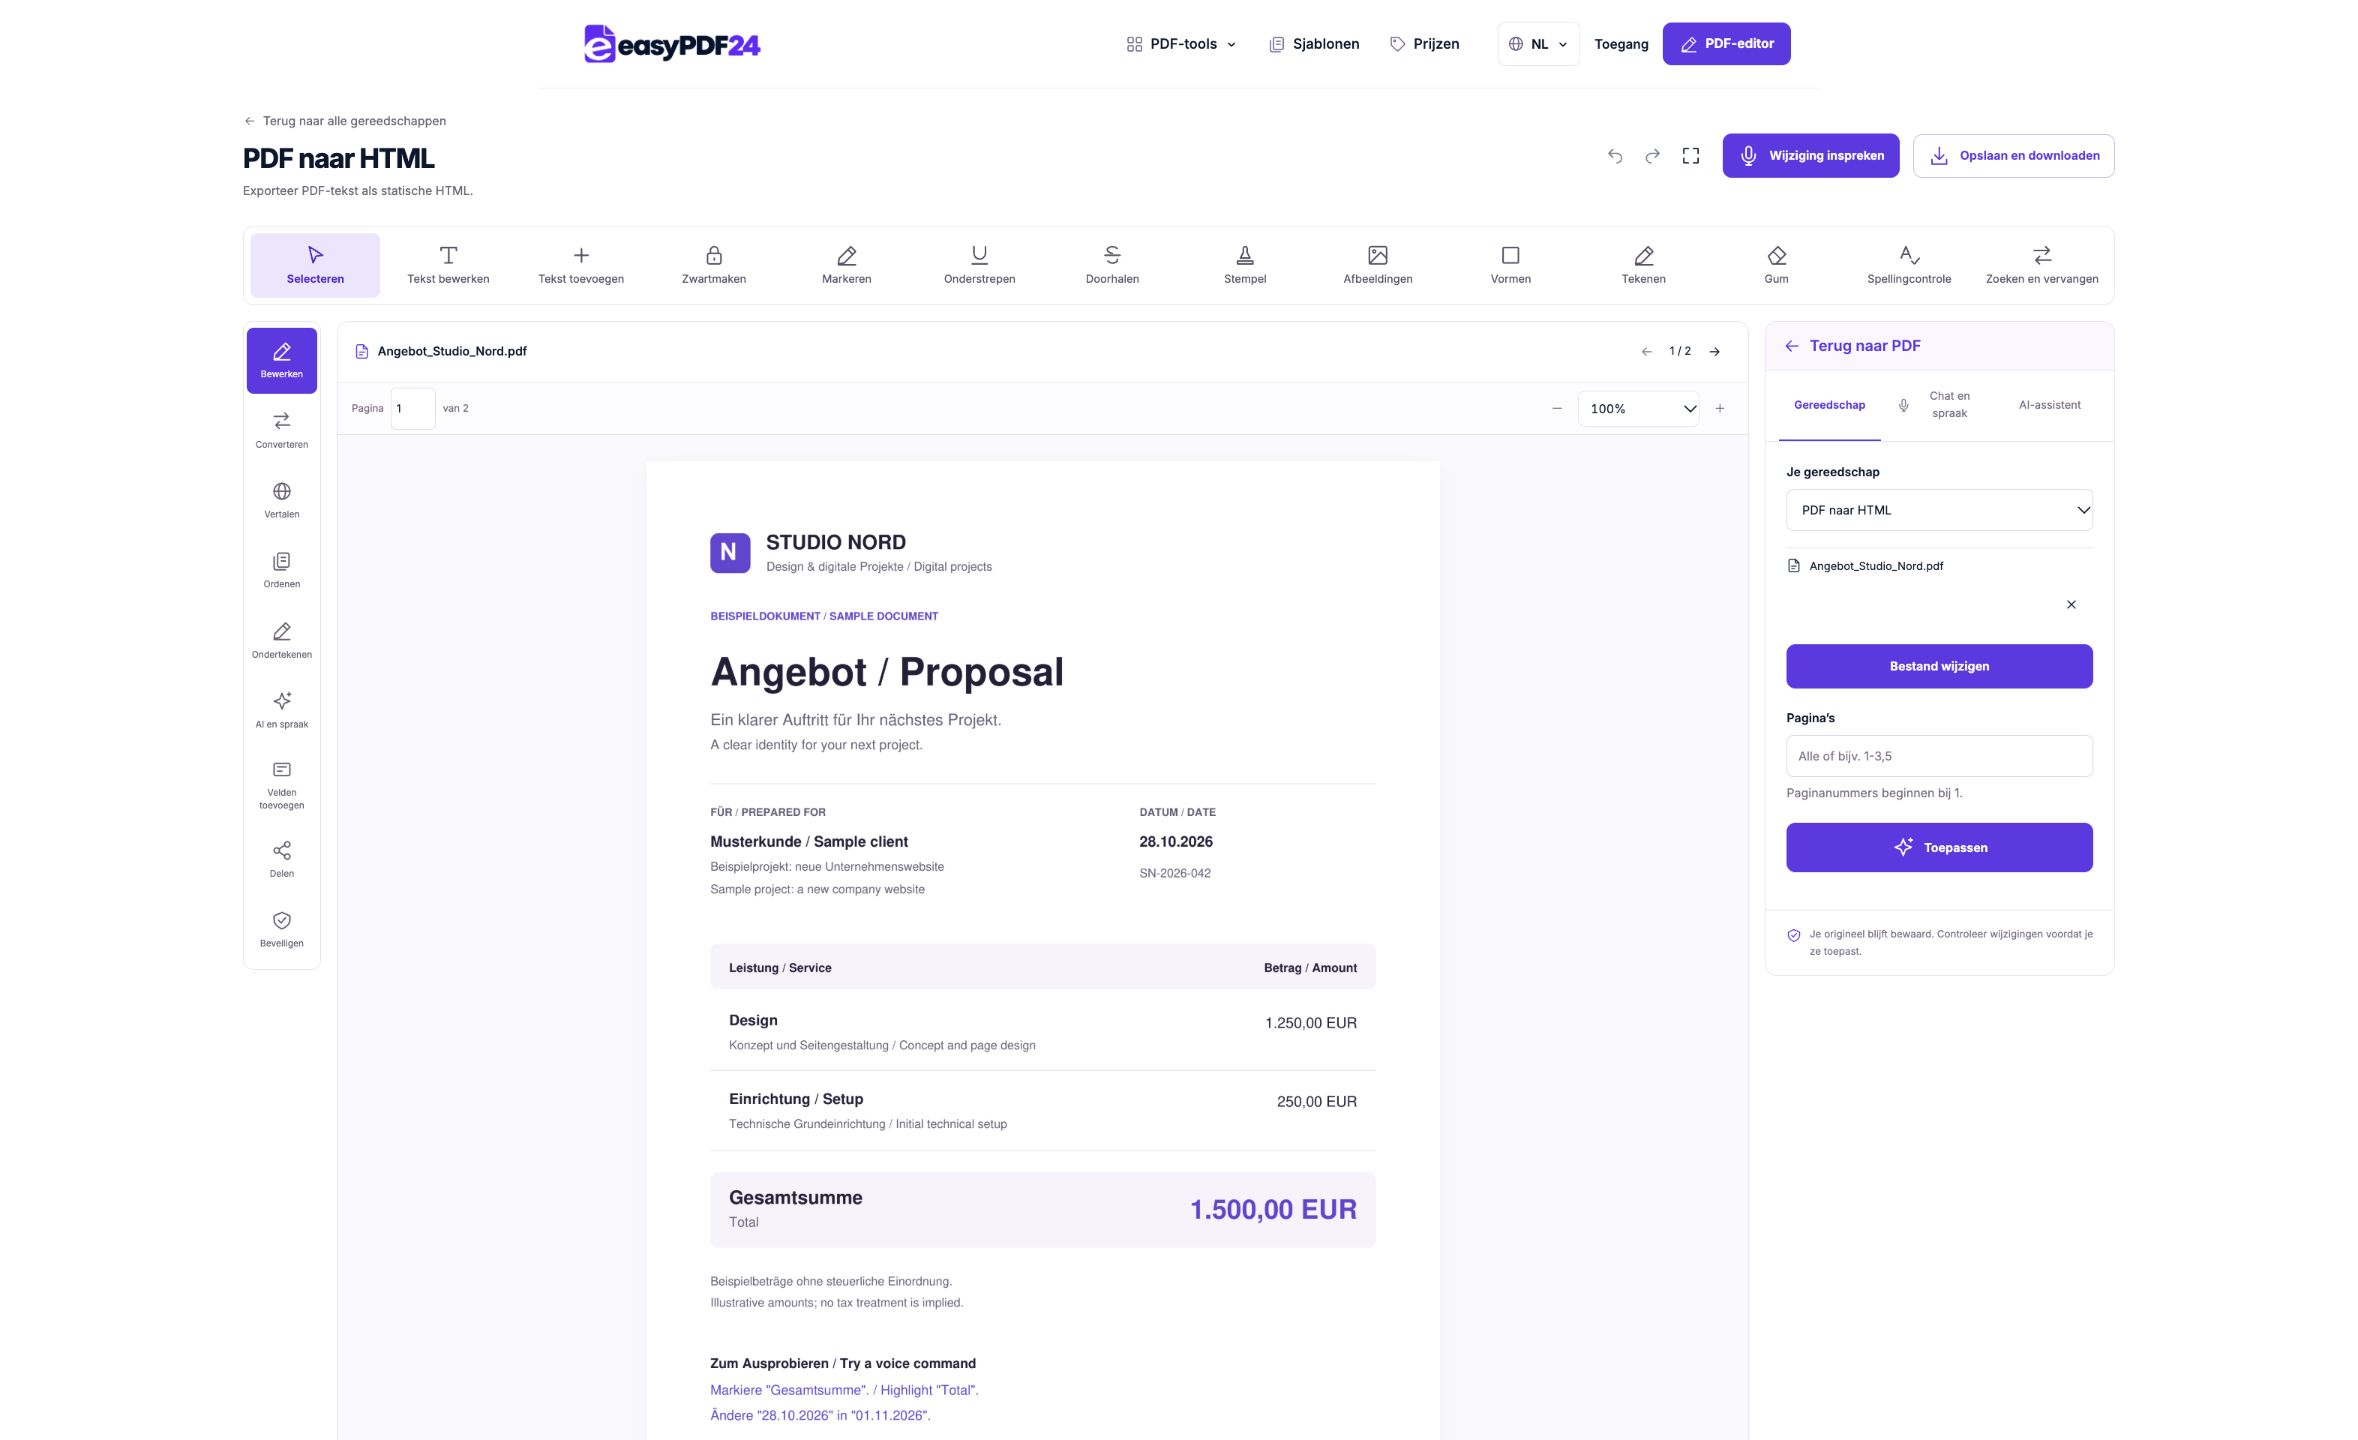
2Instellingen
Kies de HTML-export en laat het tekstbestand maken.
3Toepassen
PDF → HTML
4Voor en na
Visuele pagina → Uitgelezen tekst
5Controleren
Vergelijk namen, getallen en bijzondere tekens Controleer leesvolgorde en alinea’s Open het gedownloade bestand opnieuw
6Opslaan
Open het resultaat en controleer de leesvolgorde, tekens en paginakoppen.
Voorbeeld
Voor
Visuele pagina
Na
Uitgelezen tekst
Controleer deze punten in het resultaat
- Vergelijk namen, getallen en bijzondere tekens
- Controleer leesvolgorde en alinea’s
- Open het gedownloade bestand opnieuw
Een vertrekpunt voor verdere webbewerking
De export bevat tekst met koppen die de bronpagina’s herkenbaar maken. Je kunt die inhoud daarna zelf indelen voor een website of ander HTML-gebruik. Tabellen, afbeeldingen en kolomindelingen worden niet in hun oorspronkelijke ontwerp gereconstrueerd. Bij documenten met meerdere kolommen is het belangrijk na te gaan of zinnen nog in de juiste volgorde staan.
Controleer de tekst vóór publicatie
De PDF-bron kan afgebroken woorden, ongebruikelijke tekens of terugkerende kop- en voetteksten bevatten. Loop die na voordat je het resultaat verder gebruikt. Een scan heeft eerst een bruikbare tekstlaag nodig. Het HTML-bestand publiceren is een aparte stap: de omzetting zet niets automatisch op een website en voegt geen eigen inhoud toe.
Veelgestelde vragen
Blijft de PDF er in HTML precies hetzelfde uitzien?
Nee. Dit is een teksexport met paginakoppen. Voor de vaste visuele weergave kun je de PDF behouden of pagina-afbeeldingen exporteren.
Kan ik HTML-code uit de PDF laten uitvoeren?
De documenttekst wordt als inhoud geëxporteerd. Tekens worden veilig verwerkt; tekst in het PDF wordt niet als actieve scripts uitgevoerd.