
Neste guia
Como fazer
Abra o PDF e selecione as páginas úteis.
Inicie a exportação para HTML.
Abra o arquivo obtido e confira o conteúdo e a ordem de leitura.
Entrada, resultado e limites
| Característica | Detalhes |
|---|---|
| Entrada | |
| Saída | HTML |
| Limite importante | Texto exportado sem reconstruir imagens, tabelas ou paginação. |
O processo em seis vistas
1Entrada
Abra o PDF e selecione as páginas úteis.
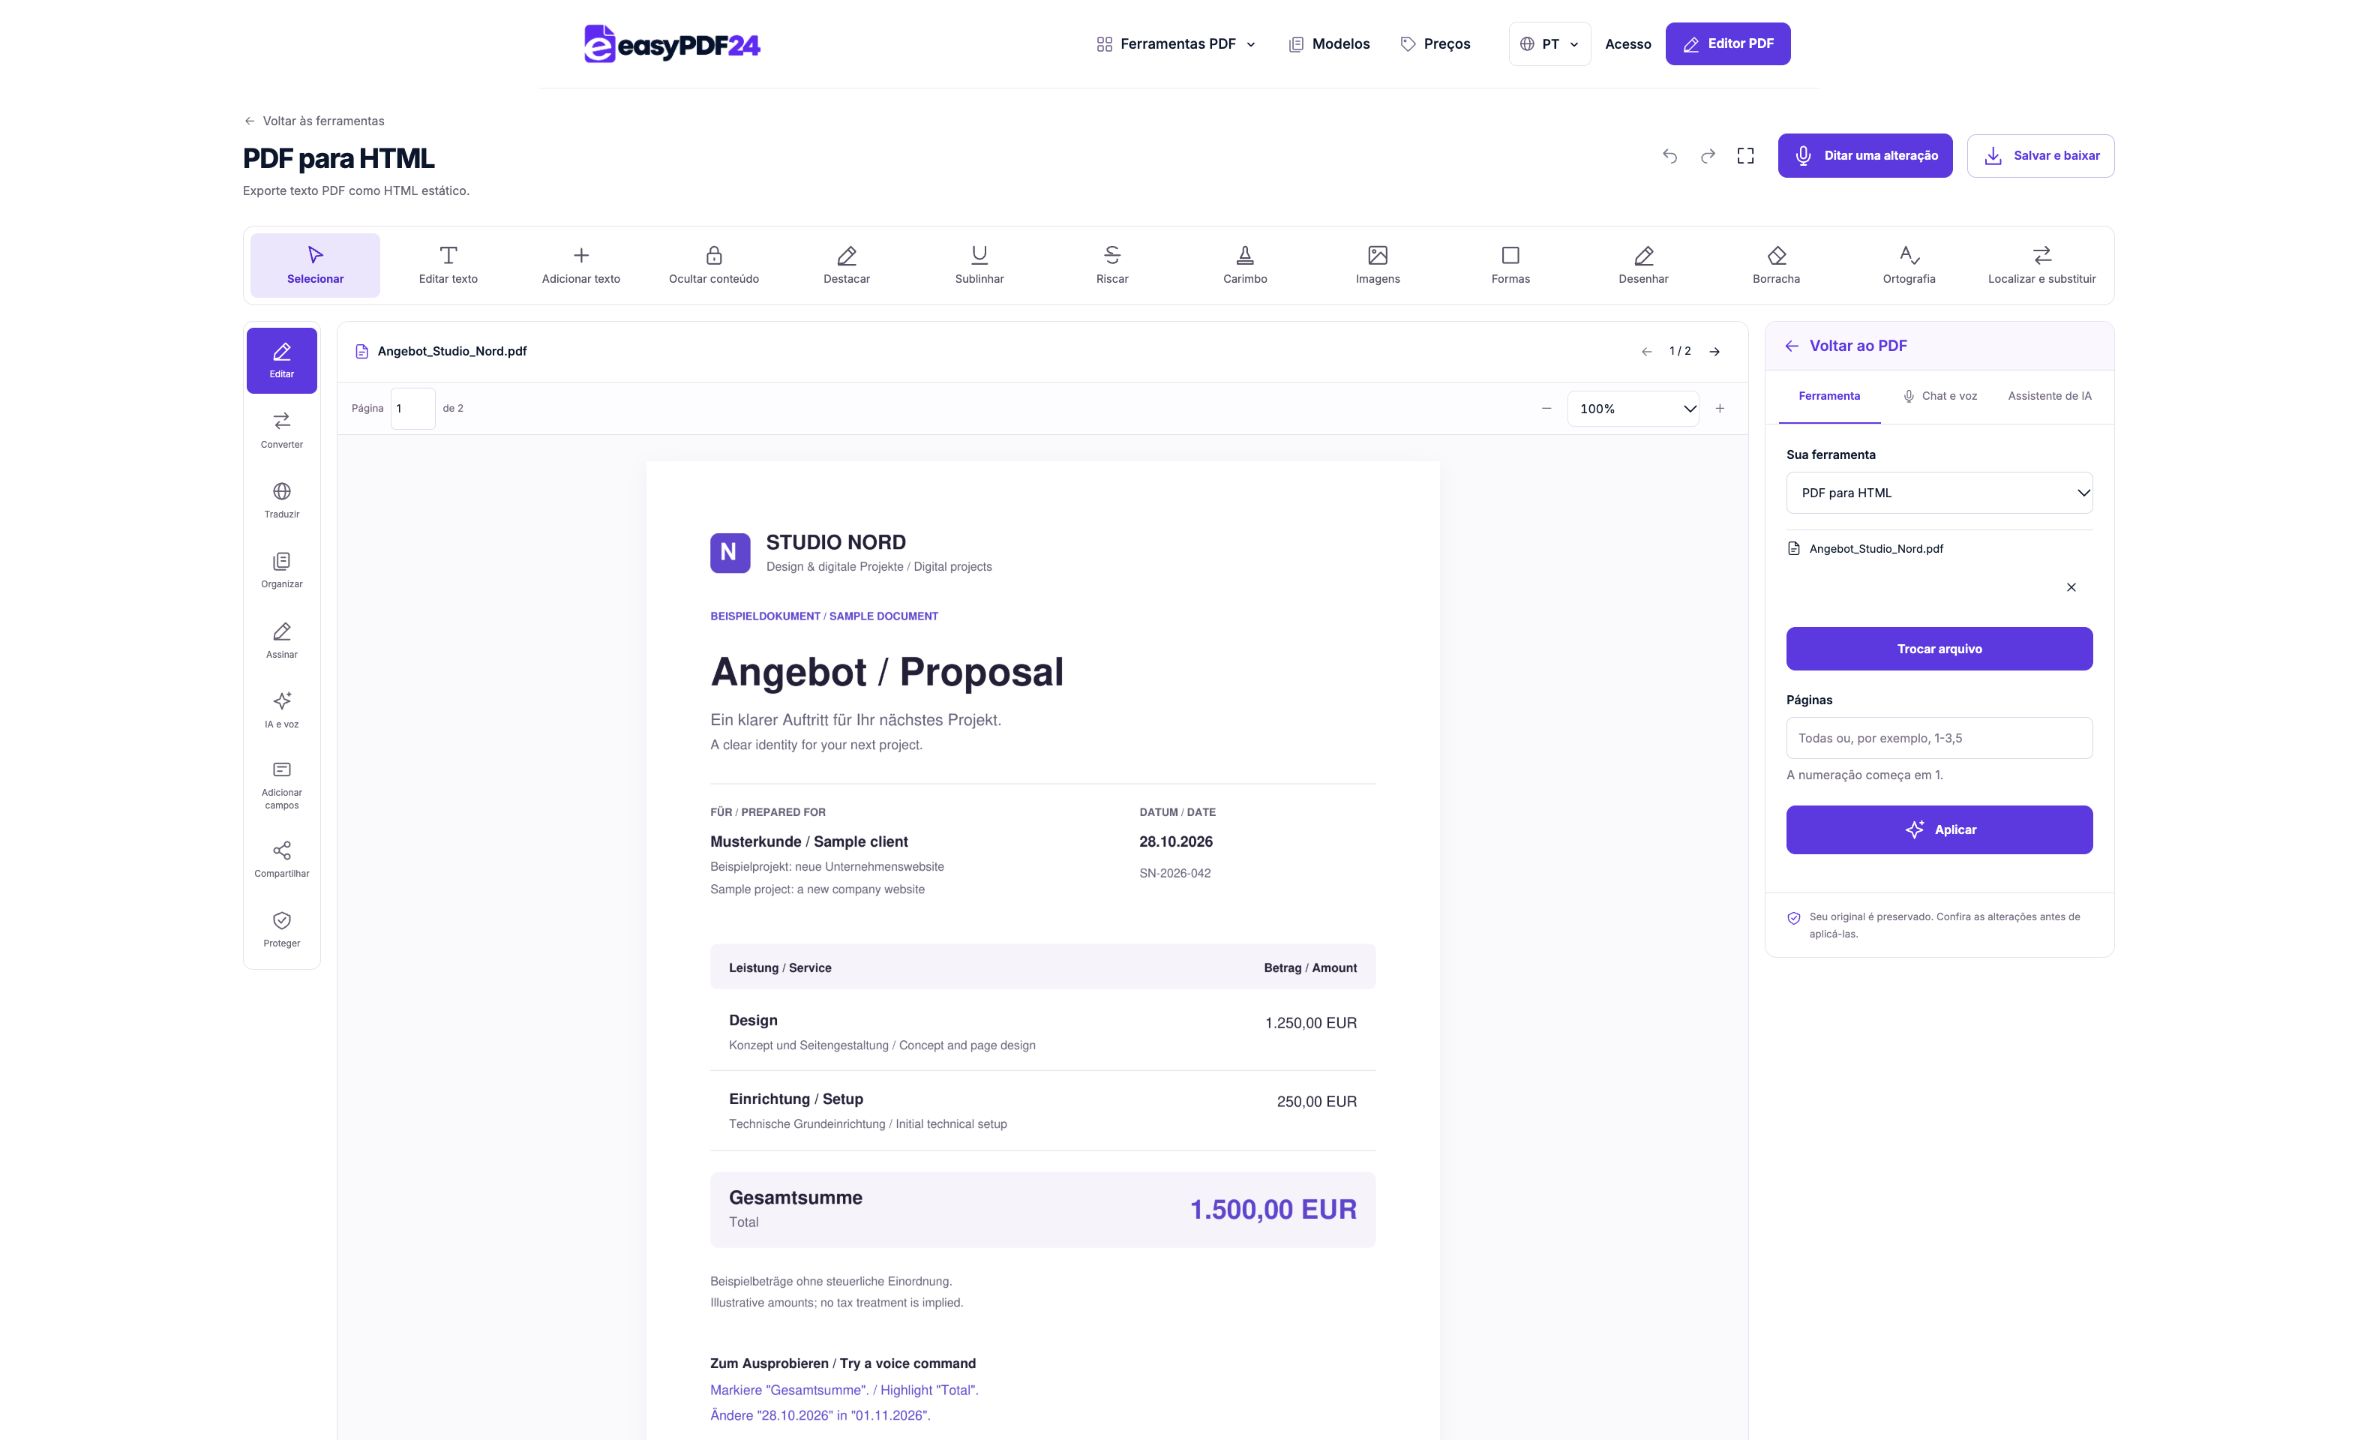
2Definições
Inicie a exportação para HTML.

3Aplicar
PDF → HTML

4Antes e depois
Página visual → Texto extraído

5Verificar
Compare nomes, números e caracteres especiais Verifique a ordem de leitura e os parágrafos Reabra o ficheiro descarregado
6Guardar
Abra o arquivo obtido e confira o conteúdo e a ordem de leitura.
Exemplo
Antes
Página visual
Depois
Texto extraído
Verifique estes pontos no resultado
- Compare nomes, números e caracteres especiais
- Verifique a ordem de leitura e os parágrafos
- Reabra o ficheiro descarregado
Uma base para editar o conteúdo
O arquivo reúne o texto extraído sob títulos de página. Ele pode servir para revisão editorial ou consulta no navegador. Não reconstrói as colunas, as tabelas, as imagens nem a diagramação do PDF original; esses elementos precisam ser tratados conforme o novo uso.
Revisar os trechos complexos
Um documento com várias colunas pode exigir correções na ordem de leitura. Confira listas, notas e unidades antes de publicar o conteúdo. Sequências que parecem código HTML são escapadas para permanecer como texto no arquivo exportado, sem se tornar instruções ativas.
Perguntas frequentes
O HTML é uma cópia visual exata?
Não. É uma exportação textual em HTML, não uma reprodução da página original.
E se o PDF contiver apenas imagens?
Primeiro ele precisa de uma camada de texto obtida por reconhecimento e revisada. Sem texto legível, a exportação não consegue recuperar as palavras.