
I den här guiden
Så gör du
Öppna en PDF med läsbar text och välj de sidor du behöver.
Starta HTML-exporten och ladda ner den skapade filen.
Öppna den i webbläsaren och kontrollera läsordning, specialtecken och stycken.
Indata, resultat och gränser
| Egenskap | Detaljer |
|---|---|
| Indata | |
| Utdata | HTML |
| Viktig begränsning | Textexport utan återskapning av bilder, tabeller eller sidlayout. |
Arbetsflödet i sex vyer

1Indata
Öppna en PDF med läsbar text och välj de sidor du behöver.

2Inställningar
Starta HTML-exporten och ladda ner den skapade filen.
3Tillämpa
PDF → HTML
4Före och efter
Visuell sida → Extraherad text
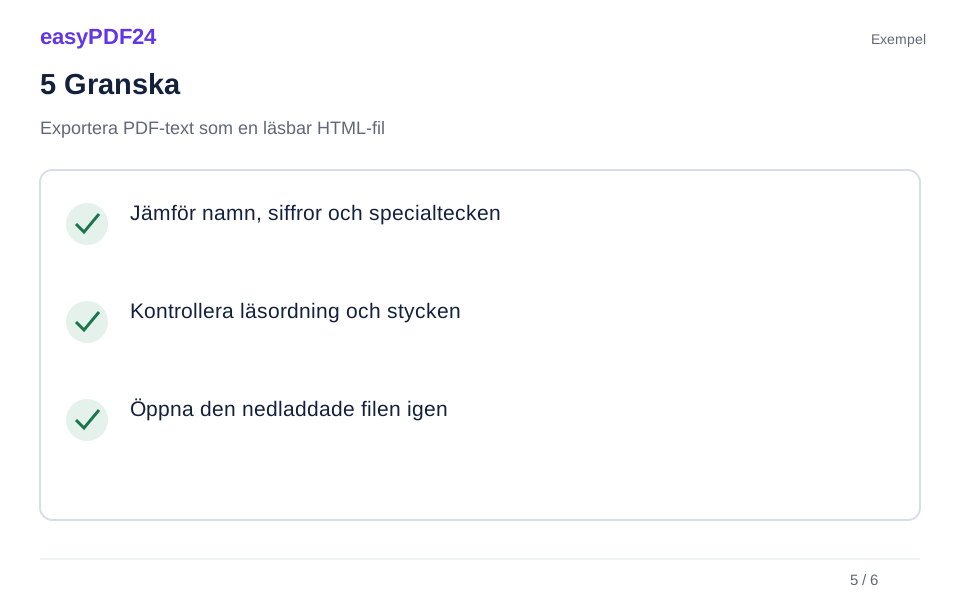
5Granska
Jämför namn, siffror och specialtecken Kontrollera läsordning och stycken Öppna den nedladdade filen igen

6Spara
Öppna den i webbläsaren och kontrollera läsordning, specialtecken och stycken.
Exempel
Före
Visuell sida
Efter
Extraherad text
Kontrollera detta i resultatet
- Jämför namn, siffror och specialtecken
- Kontrollera läsordning och stycken
- Öppna den nedladdade filen igen
Ett textunderlag att arbeta vidare med
Du kan till exempel förbereda text ur en digital PDF-handbok för en enkel webbsida. Sidrubrikerna hjälper dig att jämföra varje avsnitt med källan. Flera spalter och tabeller kan få en annan ordning i den extraherade texten än i den visuella PDF-filen. Redigera sådana avsnitt till en begriplig läsordning innan du publicerar eller återanvänder dem.
Den ursprungliga utformningen återskapas inte
Resultatet innehåller text, inte rekonstruerade bilder, tabellrutnät eller interaktiva formulär. Inbäddade program från dokumentet förs inte över. En sida som enbart är en skannad bild behöver först textigenkänning. Om utseendet är viktigare än återanvändbara formuleringar kan export av PDF-sidan som bild vara ett lämpligare nästa steg.
Vanliga frågor
Bevaras bilder och spalter?
HTML-exporten är textinriktad. Den återskapar inte bilder eller den ursprungliga spaltlayouten.
Publiceras HTML-filen automatiskt på nätet?
Nej. Du får en nedladdningsbar fil och bestämmer själv hur och var den ska användas.