
I den här guiden
Så gör du
Kontrollera om PDF-filen har markerbar text och välj de tabeller och sidor som du behöver arbeta vidare med.
Öppna PDF till Excel och välj ett lämpligt sätt att identifiera tabellen när alternativet erbjuds. Exportera till XLSX.
Jämför arbetsbokens rubriker, rader och värden med PDF-källan och bestäm datatyper innan du sorterar eller räknar.
Indata, resultat och gränser
| Egenskap | Detaljer |
|---|---|
| Indata | |
| Utdata | XLSX |
| Viktig begränsning | Tabeller blir textceller; ursprungliga formler återskapas inte. |
Bedöm källan innan du väljer arbetsflöde
Bläddra åt sidan för att se hela tabellen.
| Källa | Möjlig startpunkt | Kontrollbehov |
|---|---|---|
| Digital PDF med texttabell | Identifierade tabeller som XLSX-textceller | Jämför rader, kolumner, värden och rubriker |
| Skannad PDF | OCR som hjälp för textigenkänning | OCR garanterar inte korrekt struktur i varje cell |
| Ursprunglig Excel-arbetsbok | Arbetskälla när den finns tillgänglig | Välj rätt version med formler och samband |
Arbetsflödet i sex vyer
1Indata
Kontrollera om PDF-filen har markerbar text och välj de tabeller och sidor som du behöver arbeta vidare med.
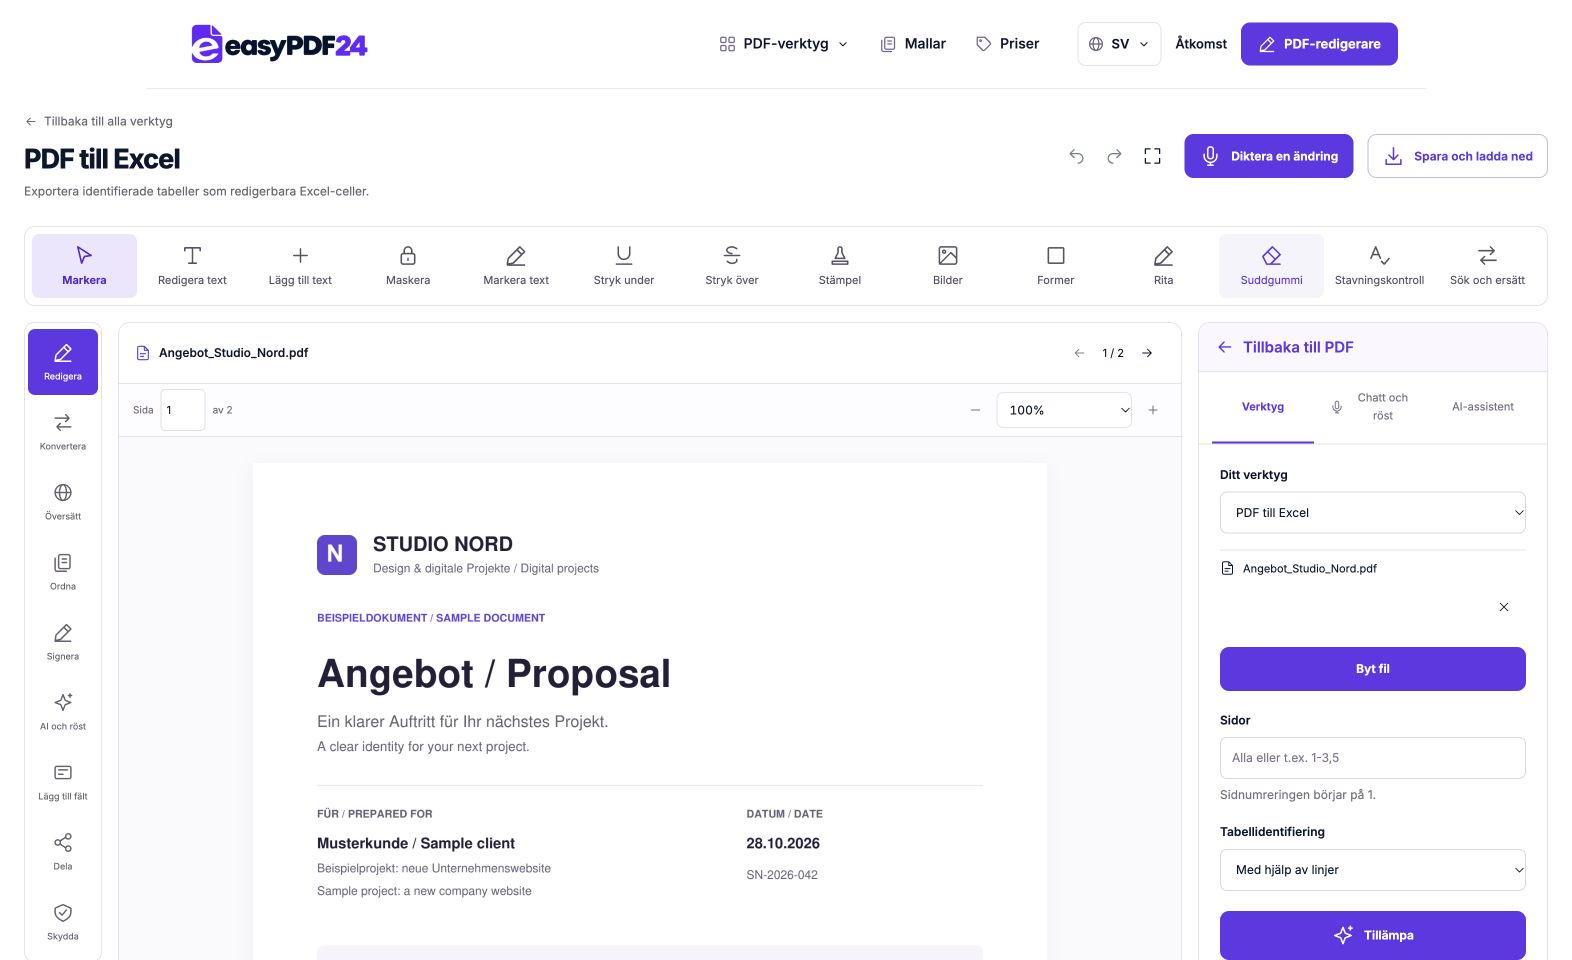
2Inställningar
Öppna PDF till Excel och välj ett lämpligt sätt att identifiera tabellen när alternativet erbjuds. Exportera till XLSX.
3Tillämpa
PDF → XLSX
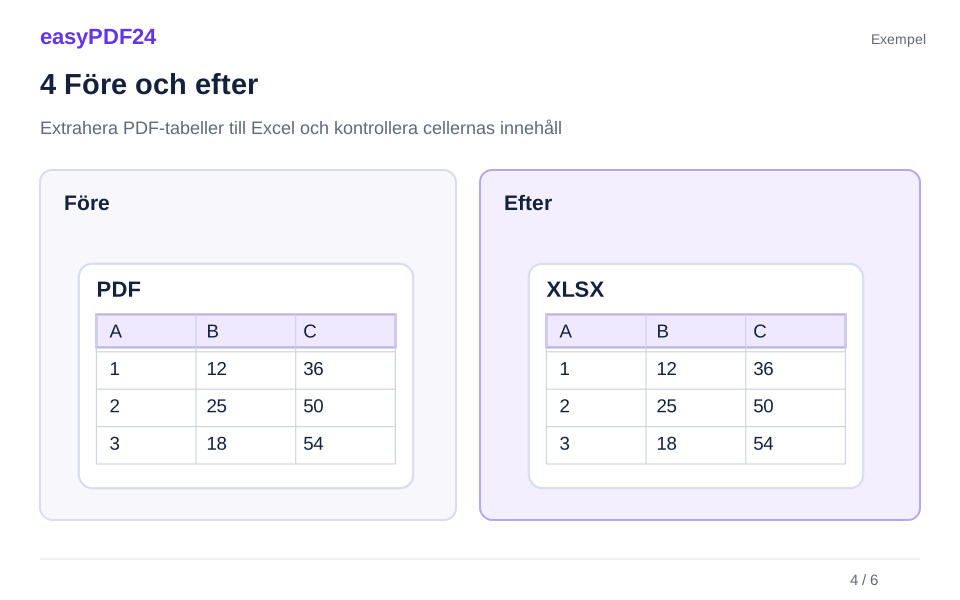
4Före och efter
En PDF-tabell fortsätter över två sidor. Kolumnrubriken upprepas på den andra sidan och en artikel har koden 00127 med inledande nollor. → Tabelldelarna granskas på sina resultatblad. Upprepade rubriker skiljs från poster, koden 00127 behålls som text och kontrollvärden jämförs med PDF-källan.
5Granska
Jämför rader, kolumner och rubrikceller Jämför namn, siffror och specialtecken Testa att nödvändiga objekt går att redigera
6Spara
Jämför arbetsbokens rubriker, rader och värden med PDF-källan och bestäm datatyper innan du sorterar eller räknar.
Exempel
Före
En PDF-tabell fortsätter över två sidor. Kolumnrubriken upprepas på den andra sidan och en artikel har koden 00127 med inledande nollor.
Efter
Tabelldelarna granskas på sina resultatblad. Upprepade rubriker skiljs från poster, koden 00127 behålls som text och kontrollvärden jämförs med PDF-källan.
Kontrollera detta i resultatet
- Jämför rader, kolumner och rubrikceller
- Jämför namn, siffror och specialtecken
- Testa att nödvändiga objekt går att redigera
En visuell tabell är inte alltid ett kalkylblad
PDF-formatet beskriver hur en sida ska visas. Det som ser ut som en tabell kan vara text på bestämda positioner, linjer och mellanrum utan en bakomliggande cellstruktur. Exporten behöver därför identifiera relationerna mellan dessa delar. Resultatet ska inte likställas med den Excel-fil som eventuellt användes för att skapa dokumentet från början. Om den ursprungliga arbetsboken finns kvar är den ofta en bättre utgångspunkt för fortsatt bearbetning.
Tabellextraktion är användbar när PDF-filen är den källa du faktiskt har, exempelvis en varulista, ett schema eller en sammanställning som behöver ordnas om. Bestäm vilken information du behöver innan du exporterar ett helt dokument. En tydlig tabell är lättare att kontrollera än en sida med flera informationsrutor som ligger nära varandra. Att en XLSX-fil kan öppnas betyder bara att ett resultat finns, inte att alla samband har tolkats korrekt. Rubriker, kolumner, rader och betydelsen av värdena behöver granskas innan filen används som underlag för ett nytt arbete.
Kontrollera om källan innehåller text eller en skannad bild
Försök markera några ord och tal i PDF-filen. Om sidan bara är en inskannad bild ska du inte förvänta dig samma förutsättningar som för en digital tabell med textobjekt. OCR kan hjälpa till att känna igen text, men teckenigenkänning och förståelse av tabellens struktur är två olika problem. Även en läsbar OCR-text kan ha fel kolumnindelning eller enstaka misstolkade siffror.
Granska källans kvalitet: snedhet, skuggor, upplösning och brutna tabellinjer kan göra arbetet svårare. Om du använder OCR som ett förberedande steg behöver resultatets tal och etiketter fortfarande jämföras med bilden. Före: bokstaven O och siffran 0 är svåra att skilja åt i ett suddigt original. Efter: den igenkända texten granskas och osäkra värden kontrolleras manuellt mot källan. Anta inte att en textmarkering bevisar att varje cell är rätt. Vissa PDF-filer har dessutom en textordning som skiljer sig från den visuella läsordningen, vilket behöver uppmärksammas även när text går att markera.
Utgå från linjer eller textpositioner efter tabellens form
Vissa tabeller har tydliga ramar runt cellerna, medan andra bara använder justering och luft mellan kolumnerna. Ett sätt att känna igen tabeller passar därför inte alla källor. När verktyget erbjuder val mellan linjer och textpositioner bör du välja utifrån den form du ser på sidan och därefter bedöma de rader och kolumner som faktiskt skapas.
Före: en tabell utan kantlinjer ger en otydlig uppdelning med en metod som söker cellramar. Efter: textpositioner prövas och resultatet jämförs med källan. Det är inte en garanti för att alla tabeller utan linjer blir perfekta. Långa texter som bryts, ojämnt placerade tal och kommentarer mellan raderna kan fortfarande ge tvetydigheter. Börja gärna med en representativ tabell och kontrollera sedan andra former separat. Om dokumentet blandar flera tabelltyper ska du inte utgå från att inställningen som fungerade på första sidan fungerar likadant på samtliga sidor. Det är strukturen i resultatet som avgör om valet var lämpligt.
Ett blad per tabell är en startpunkt för granskning
Varje identifierad tabell får ett eget blad i XLSX-resultatet. Det hjälper dig att skilja delarna åt men innebär inte att varje blad redan är en färdig, logiskt sammanhållen tabell. En tabell som fortsätter över flera PDF-sidor kan identifieras som flera delar. Rubriker som upprepas på nästa sida kan också följa med som rader som du behöver skilja från den faktiska datan.
Öppna varje blad och jämför med motsvarande del av källan. Om två blad är fortsättningar på samma tabell kan de kombineras i kalkylprogrammet efter att rubriker och radordning kontrollerats. Före: en kolumnrubrik dyker upp mitt bland posterna eftersom en ny PDF-sida började där. Efter: rubrikraden skiljs från dataraderna och delarna ordnas i rätt följd. Ta inte automatiskt bort rader som ser likadana ut. Det kan vara en delsumma eller början på en ny grupp. Ge arbetsbladen tydliga namn när du väl vet vad de innehåller, så blir nästa kontroll lättare.
Textceller kräver ett medvetet val av datatyp
De exporterade cellerna innehåller textvärden som kan redigeras. Ett värde som ser ut som ett tal behöver därför inte direkt fungera som ett beräkningsbart tal i Excel. Detta är särskilt viktigt för decimaler, tusentalsavgränsare, procent, datum och negativa belopp. Bestäm vad varje kolumn betyder innan du omvandlar den. Alla celler ska inte hanteras på samma sätt bara för att de innehåller siffror.
Artikelkoden 00127 kan behöva behålla nollorna, medan beloppet 1 250,50 behöver bli ett tal enligt rätt regionala regler. En allmän konvertering av hela bladet kan förstöra koder eller ändra datumtolkningen. Pröva därför några kontrollerade exempel först. Originalets formler återskapas inte från den tryckta tabellen. Om PDF-filen visar en totalsumma är det detta synliga värde som kan identifieras, inte den ursprungliga beräkningslogiken. När du skapar nya formler ska summorna jämföras med källans kontrollvärden. En avvikelse behöver undersökas innan du drar slutsatsen att originalet eller exporten är rätt.
Granska flernivårubriker och rader som bryts
En tabell kan ha en övergripande rubrik som gäller flera kolumner, till exempel Försäljning ovanför Januari och Februari. Sambandet är lätt att se visuellt men kan behöva ordnas manuellt i en enkel cellstruktur. Kontrollera därför rubrikerna innan du bedömer själva talen. En felaktig rubrik kan göra att samtliga värden i en kolumn tolkas på fel sätt.
Lång text som bryts över två rader kan också se ut som två separata poster efter extraktionen. Förena bara delar när du har kontrollerat att de hör till samma rad i PDF-filen. Före: ett långt produktnamn ger en extra rad och priset hamnar på en annan nivå. Efter: sambandet kontrolleras och raden rättas i arbetsboken. Fotnoter, enheter och förklaringar nära tabellen är inte alltid datarader, men kan fortfarande vara nödvändiga för förståelsen. Spara sådan information på ett tydligt ställe i arbetsmaterialet i stället för att kasta den enbart för att göra bladet mer enhetligt.
Använd kontrollvärden för att upptäcka förskjutningar
Välj några kontrollpunkter som säger något om tabellens struktur: antal rader, första och sista värdet, delsummeringar och totaler där sådana finns. Kontrollera också en rad i mitten och minst en rad som avviker, exempelvis med lång text eller ett negativt tal. Enbart slumpmässiga stickprov kan missa en förskjutning som börjar efter en viss rubrik och sedan fortsätter genom resten av tabellen.
Före: alla tal ser ut att finnas med, men en prisgrupp flyttas till fel kolumn efter en kommentar. Efter: kontrollen av raderna runt kommentaren visar var förskjutningen börjar och strukturen rättas med PDF-filen som referens. Låt inte en snyggare tabell i Excel bli ett skäl att lita på fel samband. Om uppgifterna ska importeras i ett annat system behöver kolumnordning och rubriker också stämma efter rensningen. Notera större manuella korrigeringar så att arbetet går att följa upp. Extraktion kan spara inmatningstid, men den ersätter inte förståelsen av vad varje post betyder.
Välj en arbetsyta som passar granskningens omfattning
På iPhone eller Android kan du välja en PDF genom webbläsaren och öppna en XLSX-fil med en app som stöder formatet. Många kolumner är dock besvärligare att kontrollera på en liten skärm. Börja med antal blad och kolumnrubriker och förstora de tal som behöver jämföras. Vänd enheten vid behov, men håll reda på vilken rad du följer när du flyttar dig i sidled.
Vid större datamängder är en dator ofta bekvämare eftersom källan och arbetsboken kan visas bredvid varandra. Använd tillräcklig förstoring för minustecken, decimaler och små siffror. Kontrollera att båda filerna hör till samma version. Skilj gärna mellan original-PDF, orensad export och kontrollerad arbetsbok i filnamnen. Då kan du återvända till den råa exporten om en senare ändring behöver granskas. Behåll källan tills kontrollen är klar oavsett enhet. Att en tabell går att öppna och ser prydlig ut säger inte i sig att den är färdig för beräkningar.
Behåll hela poster tillsammans när du sorterar
Efter rensningen kanske du vill sortera tabellen efter namn, datum eller belopp. Kontrollera att åtgärden omfattar alla kolumner som hör till samma post. Om bara en kolumn sorteras kan ett produktnamn skiljas från sitt pris, trots att varje enskild cell fortfarande ser rimlig ut.
Spara en arbetskopia och se om tomma rader eller återkommande rubriker delar upp uppgifterna i flera block. Markera tabellens struktur korrekt i kalkylprogrammet. Efter sorteringen jämför du kompletta poster med PDF-källan och inte bara den kolumn vars ordning ändrats. Samma princip gäller när dubbletter tas bort: två lika värden innebär inte automatiskt att två poster är samma. Bestäm kriterier efter uppgifternas betydelse och behåll källan så att ändringen går att kontrollera. En korrekt extraktion kan fortfarande förstöras av en alltför snabb bearbetning i nästa steg.
Gör arbetsboken redo för nästa konkreta uppgift
När rader och värden är kontrollerade kan du anpassa arbetsboken till användningen. En kontaktlista kan behöva textstädning och nummer som bevaras som text. En ekonomisk sammanställning kan behöva rätt datatyper och nya formler. Om flera tabeller ska slås samman bör rubriker och enheter harmoniseras först. Dessa beslut hör till databearbetningen och görs i kalkylprogrammet efter att du förstått underlaget.
Kontrollera de paket- och nedladdningsval som visas när resultatet ska sparas, och öppna sedan den fil som finns på enheten. Behåll gärna en orensad kopia innan större förändringar görs. Om den bearbetade arbetsboken senare ska bli en PDF-rapport behöver du ställa in utskriftsområde och skala i källprogrammet. Undvik onödiga omvandlingar fram och tillbaka, eftersom varje steg kan kräva nya kontroller. Målet är en användbar och begriplig tabell, inte bara en Excel-ikon. Om en del av källan är för tvetydig kan manuell inmatning av just den delen med noggrann kontroll vara den tydligaste vägen vidare.
Vanliga frågor
Återställs originalets Excel-formler?
Nej. Extraktionen ger identifierade värden som textceller och återskapar inte formler eller samband mellan arbetsblad. Om du behöver originalets beräkningsmodell bör du söka arbetsboken som användes från början. Nya formler ska baseras på kontrollerade värden.
Varför går talen inte att summera direkt?
Cellerna innehåller text. Välj datatyp i kalkylprogrammet och kontrollera decimaltecken, tusentalsavgränsare och negativa värden. Artikelnummer och andra identifierare med inledande nollor ska inte omvandlas till vanliga tal utan ett medvetet beslut.
Blir skannade tabeller perfekta med OCR?
Det kan inte garanteras. OCR känner igen tecken, medan tabellens rader och kolumner kräver ytterligare tolkning. Skanningskvalitet, linjer och teckenformer kan ge fel. Kontrollera värden och struktur mot bilden innan resultatet används.
Varför hamnar en lång tabell på flera blad?
En tabell som fortsätter över flera sidor kan identifieras som separata delar. Kontrollera att delarna hör ihop och att rubrikerna stämmer innan du kombinerar dem i kalkylprogrammet. Upprepade rader kan vara rubriker eller delsummeringar.
Ska jag välja linjer eller textpositioner?
Utgå från källans utformning. Tydliga cellramar passar en annan tolkning än kolumner som bara hålls isär med textplacering. Jämför resultatet och behandla olika tabellformer separat när de förekommer i samma dokument.
Vad behöver kontrolleras innan uppgifterna används?
Kontrollera rubriker, radantal, början och slutet samt eventuella totalsummor. Titta extra på långa texter, sammanfogade rubriker och specialtecken. För uppgifter som ska ligga till grund för viktiga beräkningar behöver varje relevant värde granskas.