
En esta guía
Cómo hacerlo
Abre el PDF, selecciona las páginas relevantes y comprueba si la tabla tiene texto seleccionable. Los escaneos que solo contienen imágenes necesitan primero una OCR apropiada.
Inicia PDF a Excel con detección adecuada: líneas para tablas delimitadas o texto para tablas sin bordes. Comprueba si se han encontrado las tablas esperadas.
Descarga el XLSX y ábrelo en una hoja de cálculo. Compara encabezados, filas y valores con el PDF, corrige las asignaciones y convierte después las celdas necesarias en números.
Entrada, resultado y límites
| Propiedad | Detalles |
|---|---|
| Entrada | |
| Salida | XLSX |
| Límite importante | Tablas como celdas de texto; no se reconstruyen las fórmulas originales. |
Elegir la fuente para seguir trabajando con datos
Desliza la tabla hacia los lados para verla completa.
| Método | Resultado | Comprobación necesaria |
|---|---|---|
| Extraer una tabla PDF | Tablas detectadas como celdas de texto editables en XLSX | Revisa columnas, cambios de página y formatos numéricos antes de calcular. |
| Aplicar OCR al escaneo primero | Texto reconocido como posible base de extracción | Comprueba caracteres y estructura; la OCR no garantiza una tabla completa. |
| Usar el XLSX original | Fórmulas, tipos de celda y hojas ya existentes | Verifica la revisión y el contenido correctos del libro. |
El proceso en seis vistas
1Entrada
Abre el PDF, selecciona las páginas relevantes y comprueba si la tabla tiene texto seleccionable. Los escaneos que solo contienen imágenes necesitan primero una OCR apropiada.
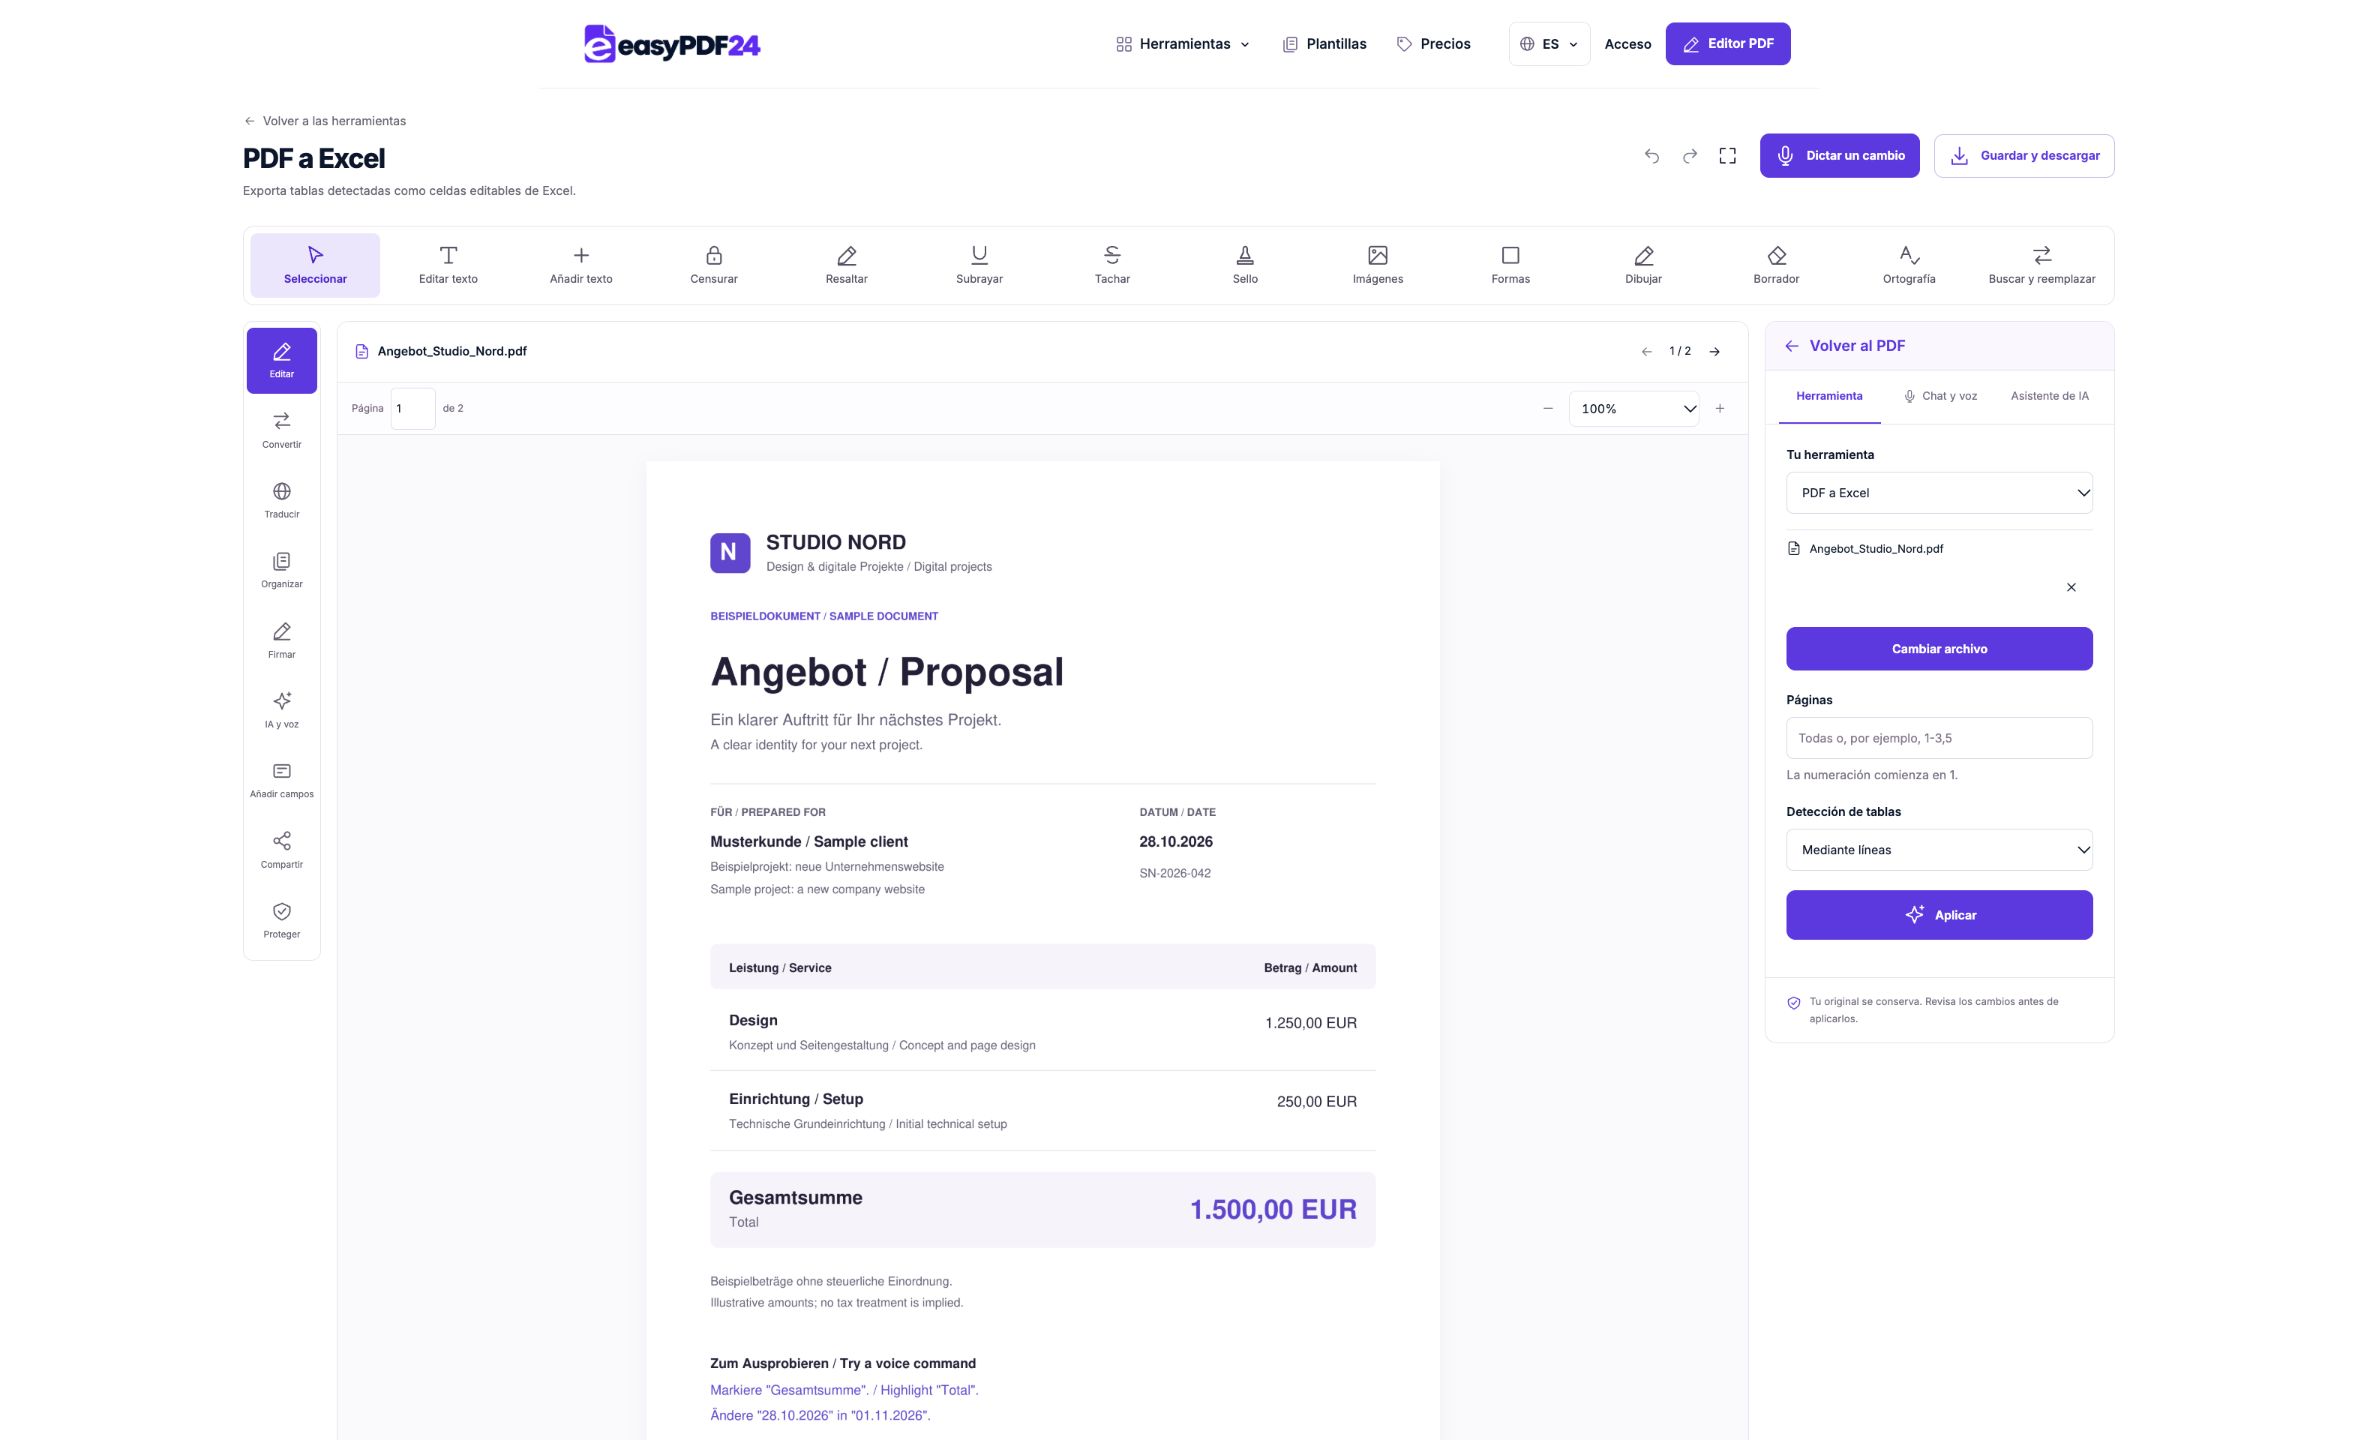
2Ajustes
Inicia PDF a Excel con detección adecuada: líneas para tablas delimitadas o texto para tablas sin bordes. Comprueba si se han encontrado las tablas esperadas.

3Aplicar
PDF → XLSX
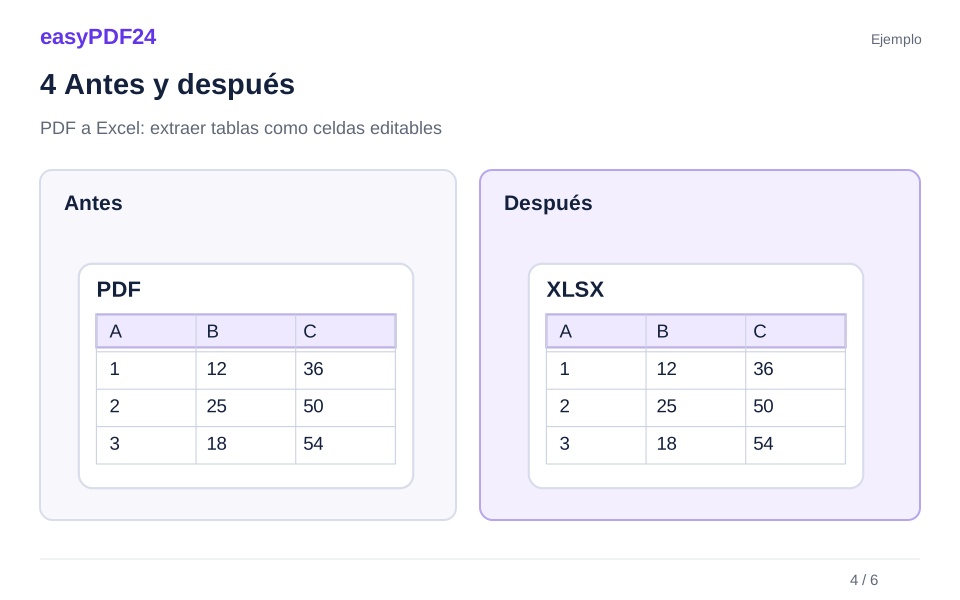
4Antes y después
Una tarifa PDF de tres páginas contiene códigos como 00124 e importes como 1.250,50, pero no se dispone de un libro original editable. → Las tablas extraídas se comparan con el PDF. Los códigos siguen como texto, los precios verificados pasan a números y solo después se añaden fórmulas de comparación nuevas.
5Revisar
Compara filas, columnas y encabezados Compara nombres, cifras y caracteres especiales Prueba la edición de los objetos necesarios
6Guardar
Descarga el XLSX y ábrelo en una hoja de cálculo. Compara encabezados, filas y valores con el PDF, corrige las asignaciones y convierte después las celdas necesarias en números.
Ejemplo
Antes
Una tarifa PDF de tres páginas contiene códigos como 00124 e importes como 1.250,50, pero no se dispone de un libro original editable.
Después
Las tablas extraídas se comparan con el PDF. Los códigos siguen como texto, los precios verificados pasan a números y solo después se añaden fórmulas de comparación nuevas.
Comprueba estos detalles del resultado
- Compara filas, columnas y encabezados
- Compara nombres, cifras y caracteres especiales
- Prueba la edición de los objetos necesarios
Una tabla en PDF no es un libro de Excel guardado
Un PDF describe principalmente la apariencia de una página. Puede mostrar cifras y líneas sin conservar las relaciones originales entre celdas. Un exportador tiene que deducir filas y columnas a partir de posiciones y otros elementos de la página. No es lo mismo que abrir un XLSX existente, por lo que no cabe esperar que reaparezcan todas sus funciones.
Si tienes el Excel original, úsalo para cálculos y edición posterior. Sus fórmulas, hojas y tipos de datos ya existen. La extracción desde PDF resulta especialmente útil cuando solo queda un informe, una tarifa u otra tabla legible. Obtienes una base para preparar los datos con control, no una reconstrucción garantizada del modelo anterior.
Comprueba primero si puedes seleccionar palabras o valores. Una fotografía contiene píxeles. La OCR puede añadir texto reconocido, pero no garantiza una estructura tabular correcta. Incluso un PDF creada digitalmente puede colocar textos de forma poco habitual. La calidad depende de la página concreta, no simplemente de que el nombre termine en .pdf. Examina el documento real antes de decidir cómo continuar.
Elegir detección por líneas o por texto
Para tablas con bordes horizontales y verticales claros, la detección por líneas es un buen punto de partida. Utiliza esas delimitaciones para identificar zonas y celdas. Tras exportar, comprueba que las columnas visibles se hayan convertido en columnas separadas. Líneas decorativas, encabezados combinados o varias tablas pequeñas pueden requerir una revisión más detallada.
En tablas sin bordes, la detección por texto puede ser más útil. Se basa en la disposición de las palabras. La alineación regular ayuda; los espacios irregulares, descripciones que ocupan varias líneas y notas dentro del área pueden generar asignaciones inesperadas. Si no aparece ninguna tabla, revisa páginas y método en lugar de reenviar la misma configuración una y otra vez.
Cambiar de método no garantiza un resultado perfecto. Compara una muestra que incluya una fila sencilla, una descripción larga y un total. Así sabrás si la estructura sirve como base. Para composiciones especiales, transferir pocos valores manualmente o pedir el libro original puede costar menos que corregir una extracción muy confusa. El criterio útil es el trabajo total necesario para obtener datos comprobables.
Entender la organización del XLSX generado
Se crea una hoja independiente para cada tabla detectada. El nombre indica la página PDF y el número de tabla, lo que ayuda a rastrear cada valor. Una tabla que continúa en varias páginas no se reúne automáticamente en una única lista con toda la lógica que hubiera tenido en Excel.
Las celdas contienen texto extraído. También un dato que parece número o fecha se guarda inicialmente como texto. Esto conserva una secuencia visible como punto de partida, pero los cálculos no necesariamente funcionarán igual que en un libro con tipos cuidadosamente definidos. Revisa y limpia antes de obtener totales, gráficos o decisiones mediante filtros.
La salida tiene una presentación sencilla y legible, no una copia de la maquetación original. No se recuperan por completo colores, combinaciones de celdas ni fórmulas. Además, cada operación admite hasta 100 tablas y 100.000 celdas. En informes grandes, selecciona rangos apropiados y revisa partes manejables. La extensión XLSX por sí sola no demuestra que el contenido esté preparado para un análisis fiable.
Tratar separadores decimales y ceros iniciales
La cadena 1.234,50 puede representar un importe en una convención regional y 1,234.50 en otra. Antes de convertir texto a números, identifica la notación de la fuente. Sustituir comas o puntos de forma indiscriminada puede cambiar valores. Revisa también espacios usados para agrupar miles y símbolos monetarios junto a las cantidades.
No toda secuencia de cifras debe convertirse en número. Códigos de producto, códigos postales e identificadores pueden necesitar ceros iniciales. En esos campos, texto suele ser el tipo adecuado. Si 00124 se transforma en 124, el identificador ha cambiado aunque la hoja parezca más ordenada. Decide por columna y finalidad, no solo por la presencia de dígitos.
Examina negativos, porcentajes y fechas por separado. Un signo menos junto al límite de una celda puede quedar asignado de otra manera. El símbolo de porcentaje cambia el significado del valor. Una fecha puede intercambiar día y mes si la configuración regional no coincide con la fuente. Realiza las conversiones conscientemente y vuelve a comparar una muestra con el PDF después de aplicarlas.
Revisar encabezados combinados y continuaciones
Un encabezado PDF puede abarcar varias columnas sin que el exportador reproduzca la combinación original de Excel. Determina qué título corresponde a cada columna. Añade encabezados claros a tu versión depurada cuando sea apropiado, en lugar de interpretar automáticamente una celda vacía como información inexistente.
Las descripciones largas son otra excepción frecuente. Un nombre puede ocupar dos líneas mientras su cantidad aparece una sola vez al lado. Comprueba si la salida conserva un registro o crea una fila aparentemente adicional. Las primeras y últimas filas de cada página merecen especial cuidado: continuaciones y límites pueden confundirse allí con más facilidad.
Cuando la tabla ocupa varias páginas, revisa primero las hojas separadas. Elimina encabezados repetidos solo después de identificar su función. Une los registros con un orden rastreable. Un total final no debe entrar como una fila ordinaria en otra suma y contarse dos veces. Conserva el XLSX sin modificar junto a tu versión de trabajo para investigar cualquier cambio posterior y distinguir un error de extracción de otro introducido al limpiar los datos.
Ejemplo: volver a trabajar con una tarifa de tres páginas
Antes de extraer, una tarifa PDF de tres páginas contiene códigos, descripciones e importes con dos decimales. Necesitas comparar varios artículos y no dispones del Excel original. Selecciona las páginas, elige un método acorde al diseño y abre el XLSX. Localiza las hojas correspondientes a esas tablas.
El código 00124 y un precio como 1.250,50 permanecen inicialmente como texto. Es una salida bruta útil, pero todavía no un modelo listo para calcular. Compara varios registros, incluyendo una descripción larga y un precio especial. Revisa si la moneda aparece en la misma celda y si un cambio de página ha partido un registro.
Después de comprobar, tu versión depurada utiliza tipos deliberados: identificador como texto, descripción como texto y precio verificado como número. Solo entonces añades las fórmulas de comparación. Son fórmulas nuevas que tú creas, no recuperadas de el PDF. Mantén referencias de página y tabla para rastrear cualquier resultado extraño. La extracción automática inicia esta revisión; no la sustituye ni demuestra por sí sola que cada dato esté correctamente interpretado.
Elegir entre OCR, copia manual y datos originales
Un PDF formado solo por imágenes necesita reconocimiento de texto antes de poder alimentar una extracción basada en texto. Influyen resolución, contraste, inclinación y claridad de los caracteres. La OCR puede confundir un cero con una O o un uno con una letra l. En listas numéricas, estas diferencias son importantes. Revisa el texto reconocido antes de confiar en una tabla deducida a partir de él.
Para pocos valores, copiar manualmente y comprobar puede ser más rápido. La extracción automática tiene más sentido con muchas filas uniformes. Decide por el esfuerzo de limpieza posterior, no únicamente por la cantidad de páginas. Una tabla compleja puede exigir más trabajo que varias tablas sencillas bien delimitadas.
La fuente original es preferible si necesitas fórmulas, tipos reales de celda o un modelo de cálculo completo. Pide XLSX, CSV u otra salida adecuada cuando sea posible. Extraer desde un PDF que ya tienes ofrece una vía práctica a celdas editables, pero no debe presentarse como prueba de que se ha reconstruido el libro anterior. Su utilidad está en proporcionar una base verificable.
Iniciar en móvil y revisar en el dispositivo adecuado
En el teléfono, selecciona el PDF desde archivos, descargas o una ubicación en la nube accesible. Guarda primero el adjunto real si procede de un correo. Identifica las páginas que contienen las tablas y limita la operación de manera razonable. Una captura es otro tipo de entrada y puede necesitar preparación de imagen u OCR antes de extraer tablas.
Abre el XLSX descargado en una aplicación de cálculo apropiada. El móvil puede bastar para una primera comprobación de filas y columnas. Una pantalla grande es normalmente más cómoda para corregir, convertir tipos y trabajar con fórmulas. Si es posible, compara PDF y hoja lado a lado en lugar de recordar cifras mientras alternas vistas pequeñas.
Conserva tres estados: PDF original, exportación sin modificar y libro depurado. Así podrás saber si un problema procede de la fuente, el reconocimiento o la edición posterior. Comparte la versión cuya estructura y cifras hayas revisado. Una apariencia ordenada debe ser consecuencia de esa revisión, no una forma de ocultar dudas sobre qué valor pertenece realmente a cada celda.
Preguntas frecuentes
¿Se recuperan las fórmulas de Excel?
No. Los contenidos detectados se escriben como texto en un XLSX. No se reconstruyen fórmulas ni la lógica original del libro. Para calcular, revisa valores, convierte las columnas apropiadas y crea fórmulas nuevas que puedas comprobar. Mantén el PDF disponible para contrastar los resultados de esas operaciones.
¿Por qué no puedo sumar inmediatamente los importes?
Las celdas se exportan como texto. Comprueba decimales, separadores de miles, monedas y espacios. Convierte solo columnas verdaderamente numéricas en tu aplicación. Los identificadores con ceros iniciales suelen necesitar seguir como texto. Vuelve a comparar algunos valores con el PDF después de cambiar sus tipos.
¿Qué hago si no se detectan tablas?
Revisa la selección y si hay texto seleccionable. En una tabla sin bordes puede funcionar mejor la detección por texto que por líneas. Los escaneos requieren OCR primero. Estructuras complejas o dañadas pueden seguir necesitando limpieza manual o datos originales; repetir la misma configuración no siempre ayuda.
¿Puedo exportar directamente una factura escaneada?
Una página de imagen no tiene celdas de texto directamente extraíbles. Realiza primero una OCR y comprueba su reconocimiento. Después puede ser posible extraer tablas, pero debes revisar cifras y asignaciones. La OCR no garantiza que la estructura completa de la factura se haya interpretado correctamente.
¿Se mantienen colores y celdas combinadas?
La salida es una tabla editable de presentación sencilla, no la reconstrucción del diseño original. Revisa títulos que abarcan columnas y descripciones de varias líneas. Aplica el formato deseado después de comprobar el contenido, para que un aspecto limpio no oculte errores de correspondencia.
¿Hay límites para informes grandes?
Cada operación admite hasta 100 tablas y 100.000 celdas. Selecciona rangos de páginas adecuados y trabaja por partes manejables. Revisa cada parte antes de unir datos. Presta atención a encabezados repetidos, continuaciones y totales en los límites, para evitar omisiones o duplicaciones durante la consolidación.