
En esta guía
Cómo hacerlo
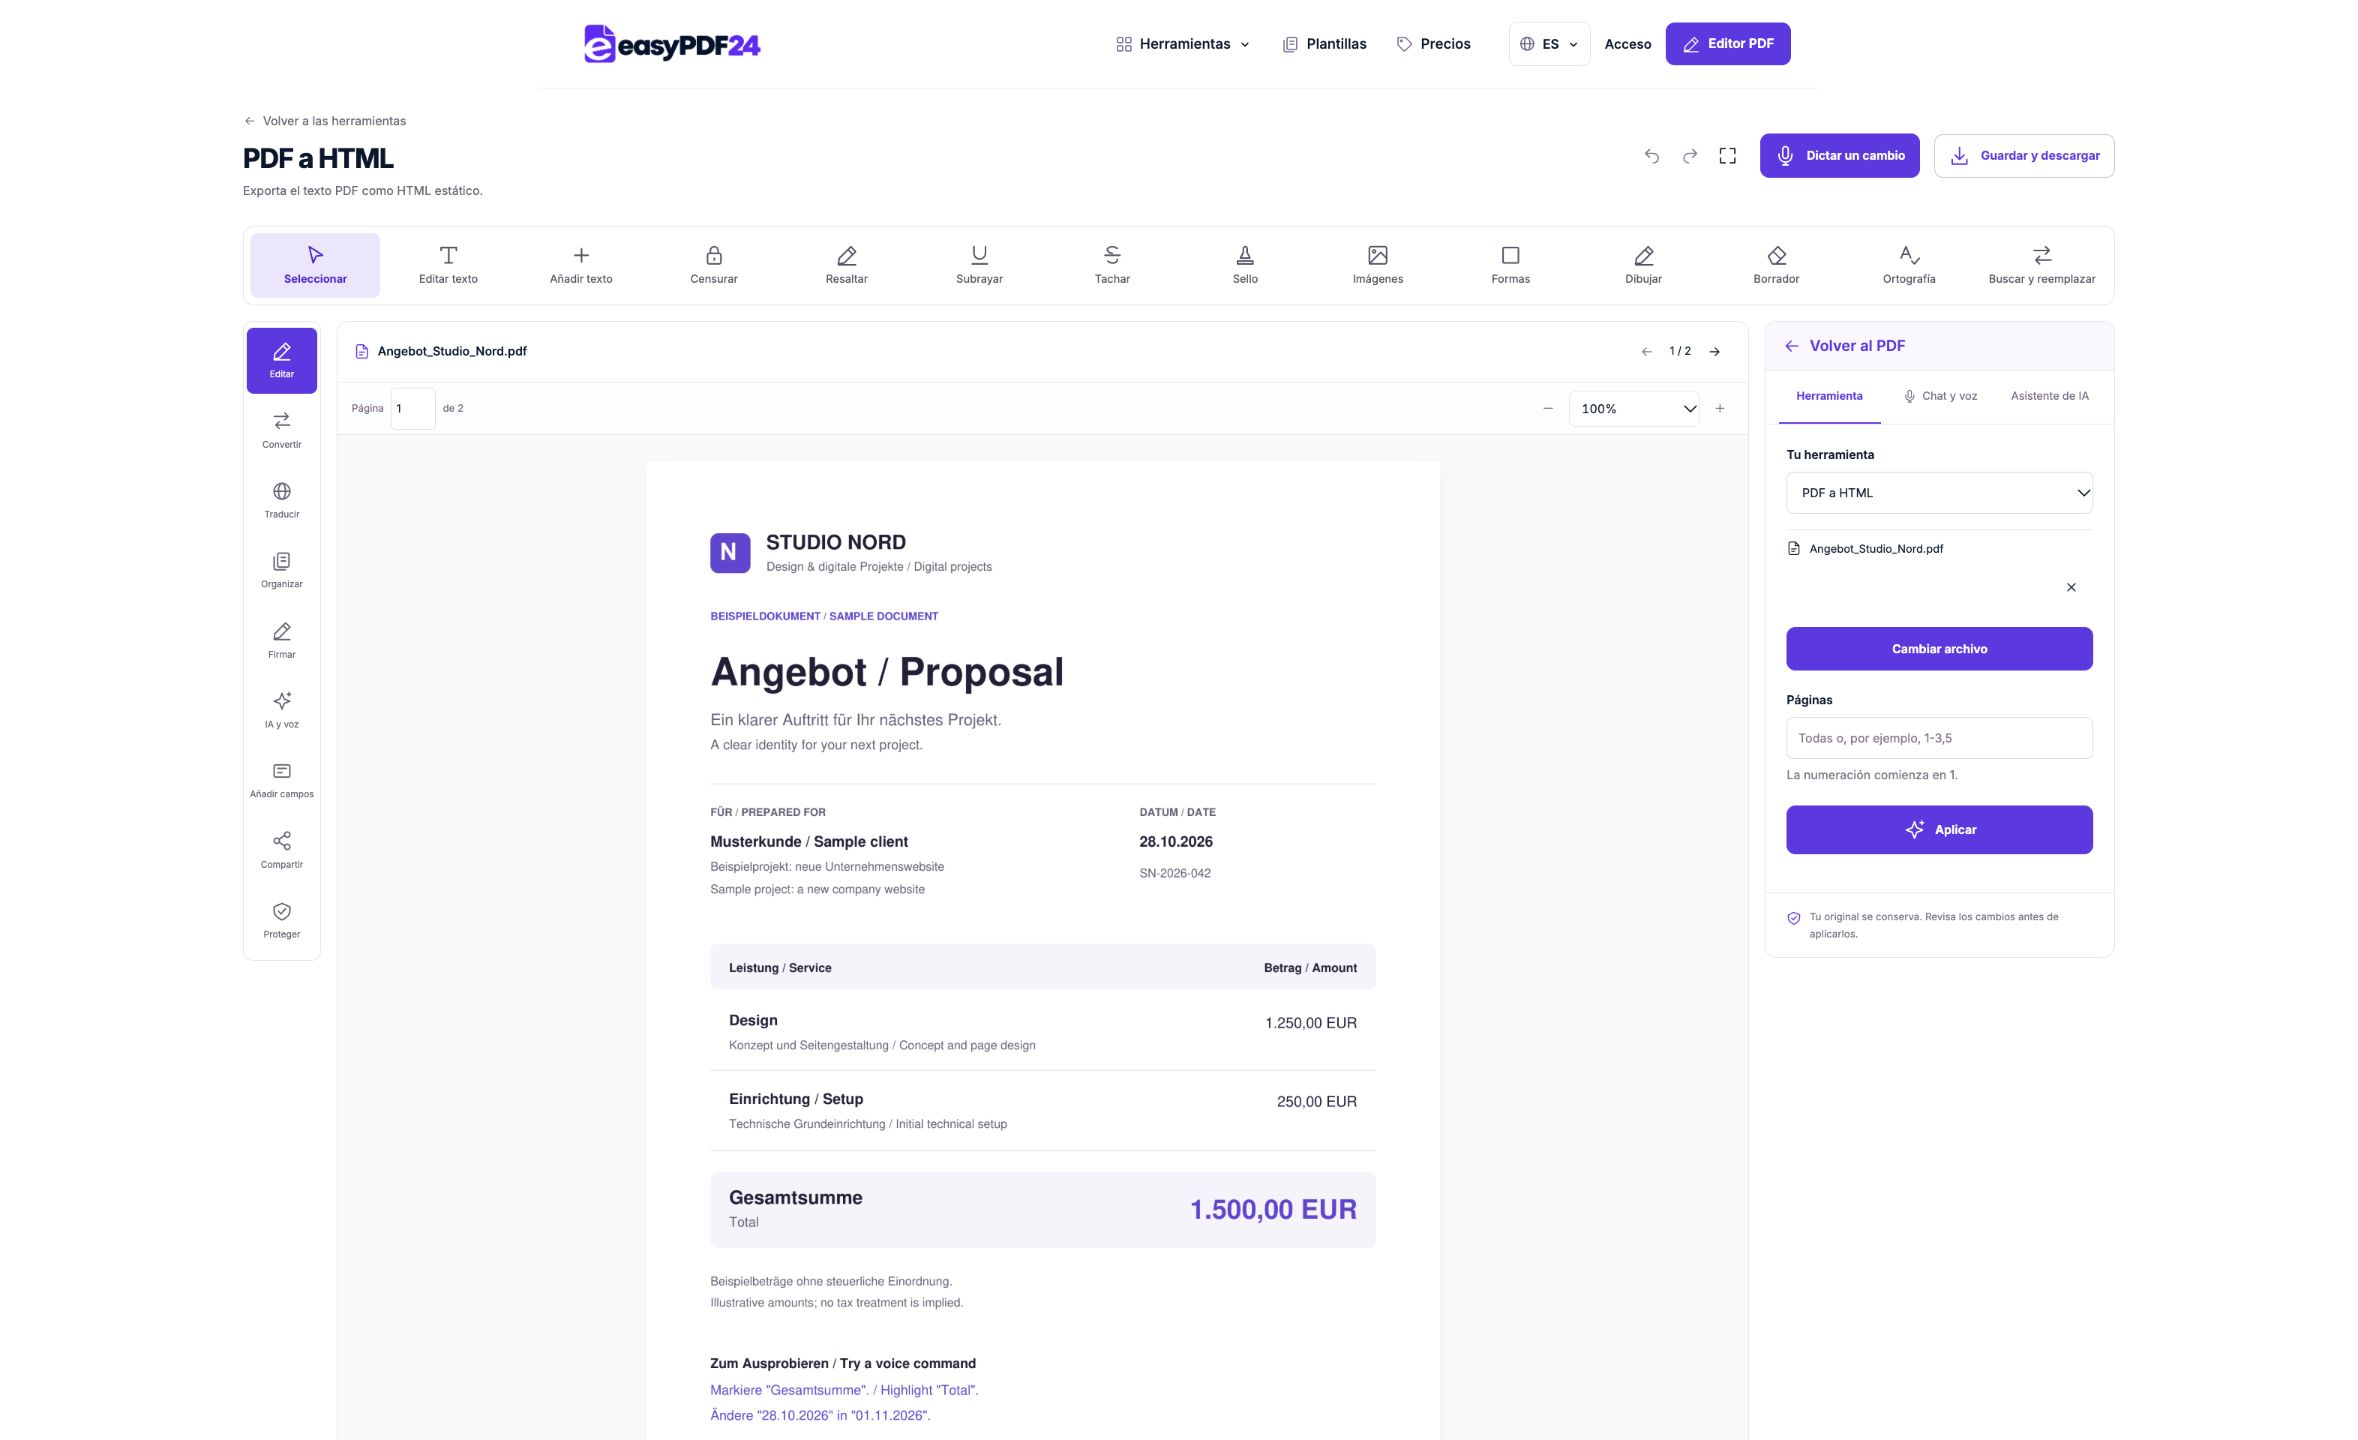
Abre el PDF y selecciona las páginas útiles.
Inicia la exportación a HTML.
Abre el archivo obtenido y comprueba el contenido y su orden de lectura.
Entrada, resultado y límites
| Propiedad | Detalles |
|---|---|
| Entrada | |
| Salida | HTML |
| Límite importante | Salida de texto sin reconstruir imágenes, tablas ni diseño de página. |
El proceso en seis vistas

1Entrada
Abre el PDF y selecciona las páginas útiles.
2Ajustes
Inicia la exportación a HTML.
3Aplicar
PDF → HTML
4Antes y después
Página visual → Texto extraído

5Revisar
Compara nombres, cifras y caracteres especiales Comprueba orden de lectura y párrafos Vuelve a abrir el archivo descargado

6Guardar
Abre el archivo obtenido y comprueba el contenido y su orden de lectura.
Ejemplo
Antes
Página visual
Después
Texto extraído
Comprueba estos detalles del resultado
- Compara nombres, cifras y caracteres especiales
- Comprueba orden de lectura y párrafos
- Vuelve a abrir el archivo descargado
Una base para la edición del contenido
El archivo reúne el texto extraído bajo encabezados de página. Puede servir para una revisión editorial o para consultar el contenido en el navegador. No reconstruye las columnas, las tablas, las imágenes ni el diseño gráfico del PDF original.
Revisar los pasajes complejos
Un documento con varias columnas puede requerir correcciones en el orden de lectura. Revisa listas, notas y unidades antes de publicar el contenido. Las cadenas que parecen código HTML se escapan para que sigan apareciendo como texto en el archivo generado.
Preguntas frecuentes
¿El HTML es una copia visual exacta?
No. Es una exportación del texto en formato HTML, no una reproducción de la página original.
¿Qué ocurre si el PDF solo contiene imágenes?
Primero necesita una capa de texto obtenida mediante reconocimiento y revisada por ti. Sin texto legible, esta exportación no puede recuperar las palabras.