
In questa guida
Come procedere
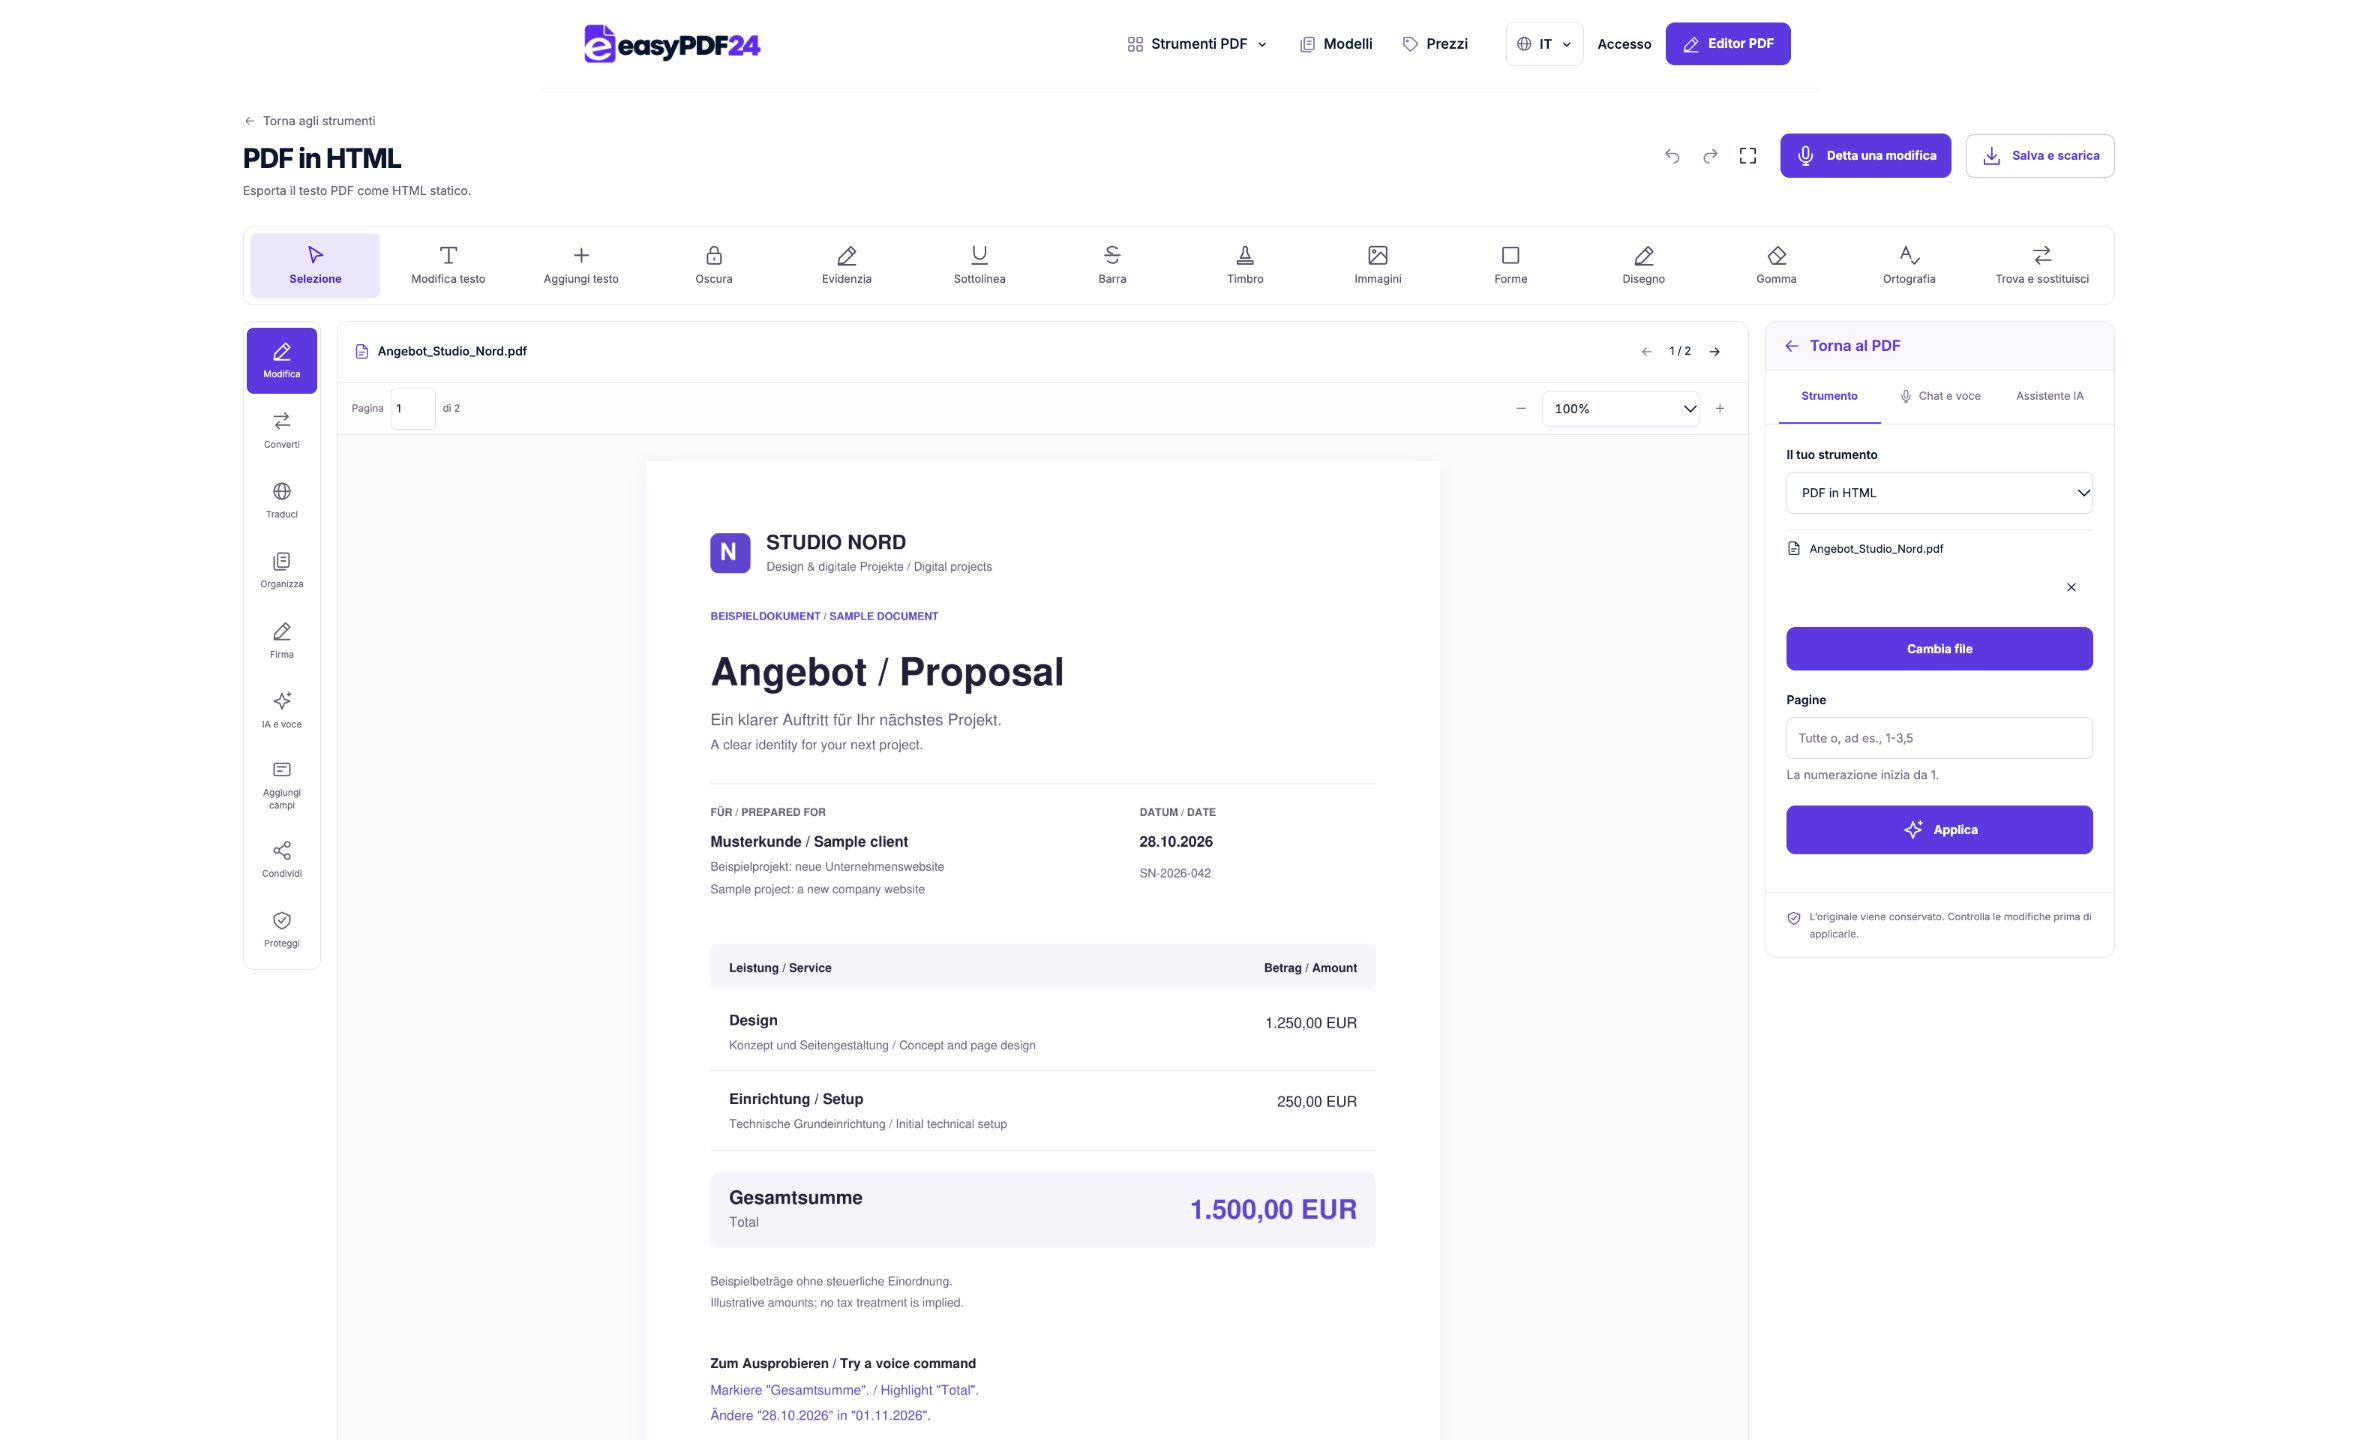
Apri il PDF e seleziona le pagine utili.
Avvia l’esportazione HTML.
Apri il file ottenuto e verifica contenuto e ordine di lettura.
Dati, risultato e limiti
| Caratteristica | Dettagli |
|---|---|
| Dati in ingresso | |
| Risultato | HTML |
| Limite importante | Testo esportato senza ricostruire immagini, tabelle o impaginazione. |
Il flusso in sei viste

1Dati iniziali
Apri il PDF e seleziona le pagine utili.
2Impostazioni
Avvia l’esportazione HTML.

3Applica
PDF → HTML

4Prima e dopo
Pagina visiva → Testo estratto

5Verifica
Confronta nomi, numeri e caratteri speciali Controlla ordine di lettura e paragrafi Riapri il file scaricato
6Salva
Apri il file ottenuto e verifica contenuto e ordine di lettura.
Esempio
Prima
Pagina visiva
Dopo
Testo estratto
Controlla questi aspetti del risultato
- Confronta nomi, numeri e caratteri speciali
- Controlla ordine di lettura e paragrafi
- Riapri il file scaricato
Una base per rielaborare il contenuto
Il file riunisce il testo estratto sotto titoli di pagina. Può servire per una revisione editoriale oppure per consultare il contenuto nel browser. Non ricostruisce colonne, tabelle, immagini o lo stile grafico del PDF originale.
Controllare i passaggi complessi
Un PDF con più colonne può richiedere correzioni nell’ordine di lettura. Rileggi elenchi, note e unità prima di pubblicare il contenuto. Le sequenze che sembrano codice HTML vengono convertite in caratteri letterali, così restano testo nel file esportato.
Domande frequenti
Il file HTML riproduce esattamente la pagina?
No. È un’esportazione testuale in HTML, non una copia dell’impaginazione originale.
Che cosa succede se il PDF contiene solo immagini?
Deve prima avere uno strato di testo ottenuto con il riconoscimento e verificato. Senza testo leggibile, questa esportazione non può recuperare le parole.