
Dalam panduan ini
Cara menggunakan
Buka PDF yang teksnya dapat diekstrak.
Pilih ekspor HTML dan buat file hasil.
Periksa urutan teks, karakter khusus, serta judul halaman.
Masukan, hasil, dan batasan
| Properti | Rincian |
|---|---|
| Masukan | |
| Keluaran | HTML |
| Batasan penting | Keluaran teks tanpa membangun ulang gambar, tabel, atau tata letak. |
Alur kerja dalam enam tampilan

1Masukan
Buka PDF yang teksnya dapat diekstrak.
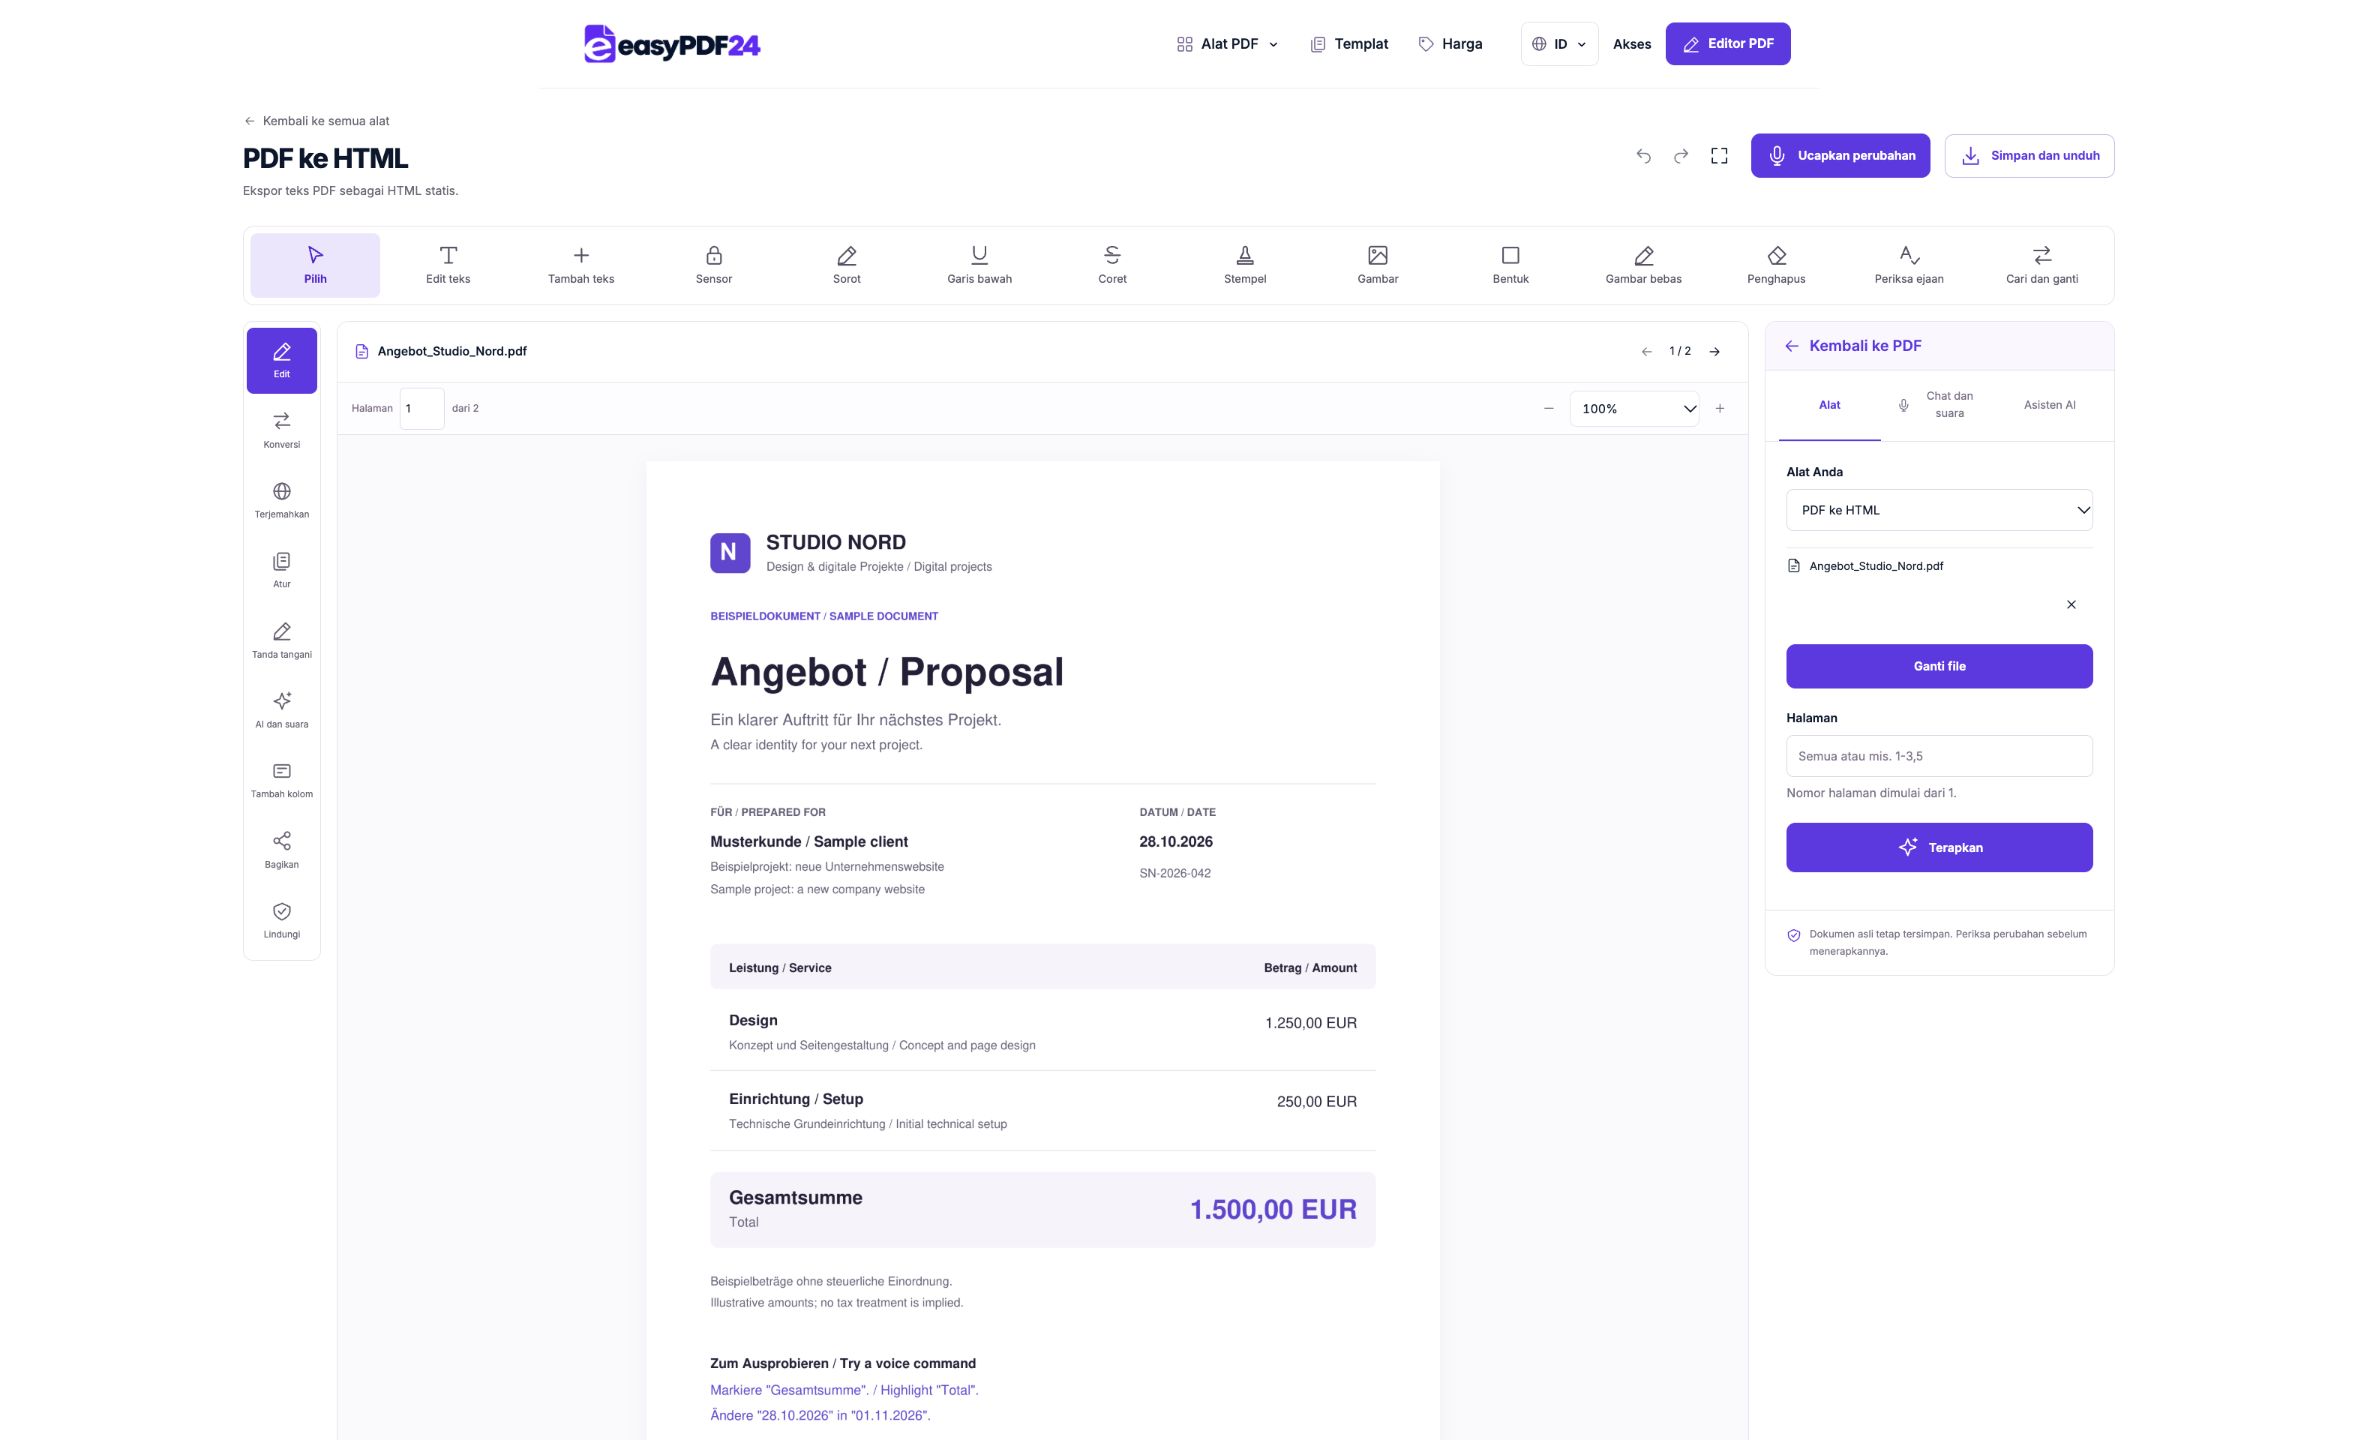
2Pengaturan
Pilih ekspor HTML dan buat file hasil.

3Terapkan
PDF → HTML

4Sebelum dan sesudah
Halaman visual → Teks yang diekstrak

5Periksa
Bandingkan nama, angka, dan karakter khusus Periksa urutan baca dan paragraf Buka ulang berkas unduhan

6Simpan
Periksa urutan teks, karakter khusus, serta judul halaman.
Contoh
Sebelum
Halaman visual
Sesudah
Teks yang diekstrak
Periksa hal berikut pada hasil
- Bandingkan nama, angka, dan karakter khusus
- Periksa urutan baca dan paragraf
- Buka ulang berkas unduhan
Dasar untuk pengolahan konten web
Judul halaman membantu menghubungkan teks dengan lokasi sumbernya. Setelah itu Anda dapat menyusun isi untuk situs atau dokumen HTML lain. Tabel, gambar, dan kolom tidak dibangun kembali dengan desain aslinya. Pada PDF beberapa kolom, periksa apakah kalimat tetap tersambung dalam urutan yang benar. Tambahkan struktur dan tautan yang diperlukan pada tahap penyuntingan berikutnya.
Periksa sebelum diterbitkan
Sumber dapat berisi kata terpotong di ujung baris, karakter tidak biasa, atau catatan kaki berulang. Tinjau bagian tersebut sebelum menggunakan hasilnya. Pindaian tanpa teks memerlukan OCR terlebih dahulu. Konversi tidak menambahkan isi baru atau menerbitkan hasil secara otomatis. Menempatkan HTML pada sebuah situs adalah langkah terpisah yang Anda lakukan sendiri.
Pertanyaan umum
Apakah HTML akan terlihat sama persis dengan PDF?
Tidak. Ini adalah ekspor teks dengan judul halaman. Untuk tampilan visual tetap, gunakan PDF atau ekspor seluruh halaman sebagai gambar.
Apakah kode dalam PDF akan dijalankan?
Teks dokumen diekspor sebagai isi dengan penanganan karakter yang sesuai. Tulisan di PDF tidak dijalankan sebagai skrip HTML aktif.