
Dalam panduan ini
Cara menggunakan
Pilih satu hingga sepuluh gambar berisi teks Jerman atau Inggris.
Tentukan bahasa pengenalan lalu buat PDF.
Periksa nama, angka, dan hasil pencarian sebelum mengunduh.
Masukan, hasil, dan batasan
| Properti | Rincian |
|---|---|
| Masukan | JPG / PNG / WebP |
| Keluaran | |
| Batasan penting | Hingga 10 gambar; OCR Jerman atau Inggris menghasilkan PDF yang dapat dicari. |
Alur kerja dalam enam tampilan
1Masukan
Pilih satu hingga sepuluh gambar berisi teks Jerman atau Inggris.
2Pengaturan
Tentukan bahasa pengenalan lalu buat PDF.
3Terapkan
JPG / PNG / WebP → PDF

4Sebelum dan sesudah
Halaman visual → Teks yang diekstrak
5Periksa
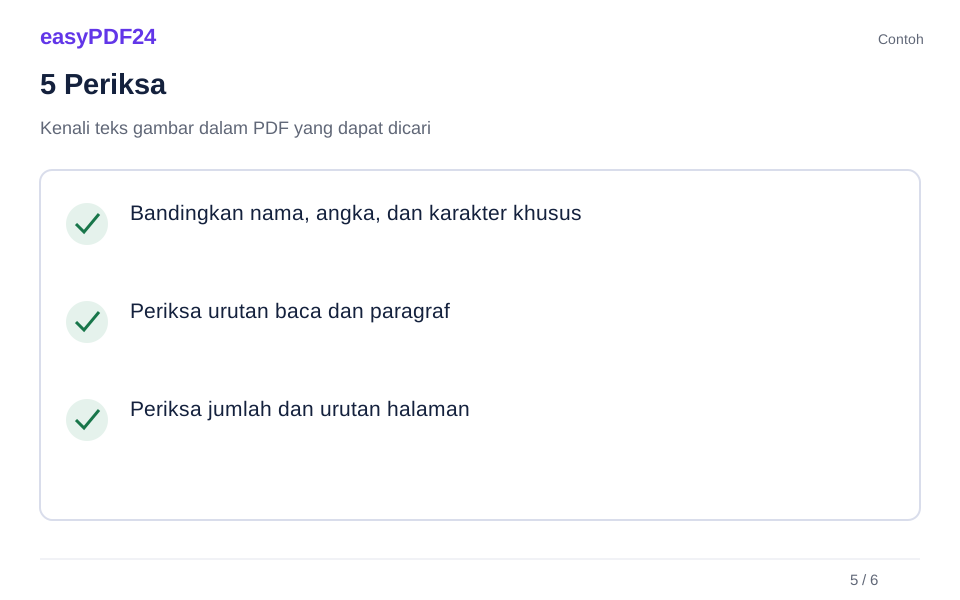
Bandingkan nama, angka, dan karakter khusus Periksa urutan baca dan paragraf Periksa jumlah dan urutan halaman
6Simpan
Periksa nama, angka, dan hasil pencarian sebelum mengunduh.
Contoh
Sebelum
Halaman visual
Sesudah
Teks yang diekstrak
Periksa hal berikut pada hasil
- Bandingkan nama, angka, dan karakter khusus
- Periksa urutan baca dan paragraf
- Periksa jumlah dan urutan halaman
Gunakan gambar yang jelas
Gambar tajam, tegak, dan terang merata membantu proses pengenalan. Untuk dokumen yang difoto miring, gunakan pemindai terlebih dahulu guna memperbaiki perspektif dan tepi halaman. JPEG, PNG, WebP, dan HEIC termasuk format yang diterima. Animasi serta berkas gambar dengan beberapa halaman tidak didukung dalam proses ini.
Simpan gambar asli sebagai acuan
Total gambar dapat mencapai 25 MiB, dengan paling banyak 40 megapiksel per gambar. Gambar disesuaikan ke halaman A4. OCR menambahkan teks yang dapat dicari, tetapi tidak membangun ulang tata letak dokumen yang sepenuhnya dapat disunting. Huruf kecil, tulisan tangan, kontras rendah, atau karakter tidak biasa dapat menimbulkan kesalahan.
Pertanyaan umum
Bisakah saya mengenali teks bahasa Indonesia?
Saat ini alat menyediakan bahasa Jerman dan Inggris. Pilih bahasa yang sesuai dengan teks sumber.
Apakah teks yang dikenali menggantikan gambar?
Tidak. Gambar tetap terlihat dan mendapat lapisan teks tambahan. Bandingkan informasi yang disalin dengan halaman aslinya.