
W tym poradniku
Jak to zrobić
Wybierz od jednego do dziesięciu obrazów z tekstem niemieckim lub angielskim.
Ustaw język rozpoznawania i utwórz PDF.
Przed pobraniem sprawdź nazwiska, liczby oraz wyniki wyszukiwania.
Dane, wynik i ograniczenia
| Właściwość | Szczegóły |
|---|---|
| Dane wejściowe | JPG / PNG / WebP |
| Wynik | |
| Ważne ograniczenie | Do 10 obrazów; OCR niemiecki lub angielski tworzy PDF z wyszukiwaniem. |
Przebieg w sześciu widokach
1Dane wejściowe
Wybierz od jednego do dziesięciu obrazów z tekstem niemieckim lub angielskim.

2Ustawienia
Ustaw język rozpoznawania i utwórz PDF.
3Zastosowanie
JPG / PNG / WebP → PDF
4Przed i po
Wizualna strona → Wyodrębniony tekst
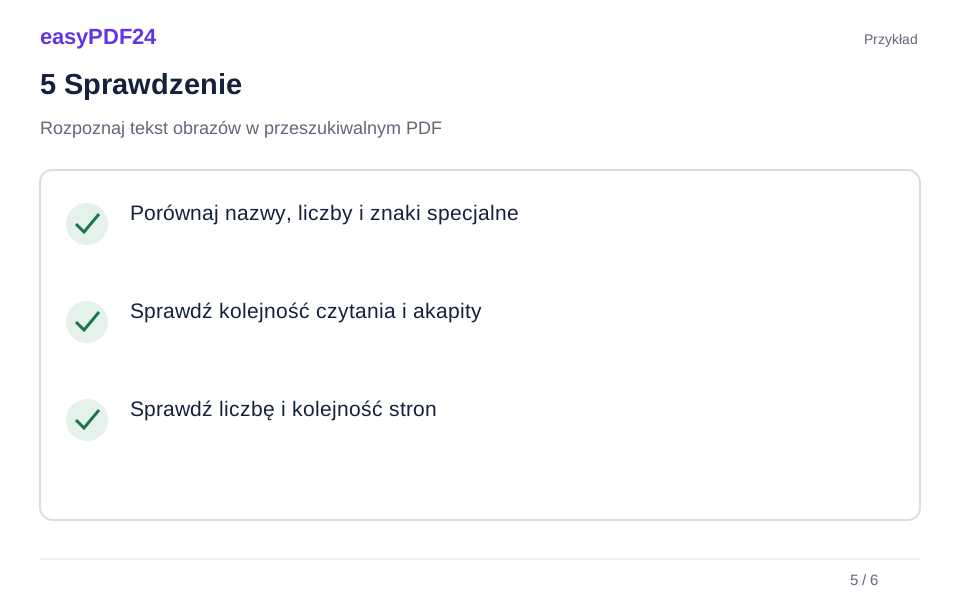
5Sprawdzenie
Porównaj nazwy, liczby i znaki specjalne Sprawdź kolejność czytania i akapity Sprawdź liczbę i kolejność stron
6Zapis
Przed pobraniem sprawdź nazwiska, liczby oraz wyniki wyszukiwania.
Przykład
Przed
Wizualna strona
Po
Wyodrębniony tekst
Sprawdź te elementy wyniku
- Porównaj nazwy, liczby i znaki specjalne
- Sprawdź kolejność czytania i akapity
- Sprawdź liczbę i kolejność stron
Przygotuj czytelne obrazy
Ostre, proste zdjęcia z równym oświetleniem ułatwiają rozpoznawanie. Przy dokumentach sfotografowanych pod kątem użyj wcześniej skanera, aby poprawić perspektywę i krawędzie strony. Obsługiwane formaty obejmują JPEG, PNG, WebP i HEIC. Animacje oraz wielostronicowe pliki obrazów nie są tutaj obsługiwane.
Zachowaj oryginał jako punkt odniesienia
Obrazy mogą łącznie zajmować 25 MiB, przy maksymalnie 40 megapikselach na obraz. Są dopasowywane do stron A4. OCR dodaje przeszukiwalny tekst, ale nie odtwarza w pełni edytowalnego układu dokumentu. Drobny druk, pismo ręczne, niski kontrast lub nietypowe znaki mogą prowadzić do błędów.
Pytania i odpowiedzi
Czy mogę rozpoznawać polski tekst?
Obecnie narzędzie oferuje niemiecki i angielski. Wybierz język odpowiadający treści źródłowej.
Czy rozpoznany tekst zastępuje obraz?
Nie. Obraz pozostaje widoczny, a tekst jest dodatkową warstwą. Porównaj skopiowane dane z oryginalną stroną.