
Dans ce guide
Comment procéder
Ouvrez le PDF et choisissez les pages utiles.
Lancez l’export HTML.
Ouvrez le fichier obtenu puis contrôlez le texte et son ordre de lecture.
Entrée, résultat et limites
| Caractéristique | Détails |
|---|---|
| Entrée | |
| Sortie | HTML |
| Limite importante | Texte exporté sans reconstruction des images, tableaux ou de la mise en page. |
Le parcours en six vues
1Entrée
Ouvrez le PDF et choisissez les pages utiles.

2Réglages
Lancez l’export HTML.

3Appliquer
PDF → HTML
4Avant et après
Page visuelle → Texte extrait
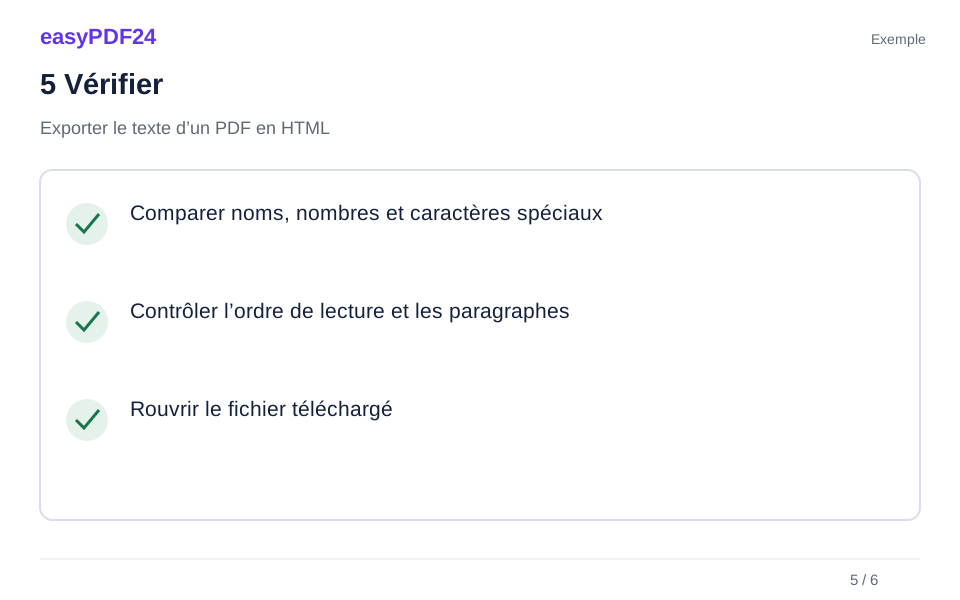
5Vérifier
Comparer noms, nombres et caractères spéciaux Contrôler l’ordre de lecture et les paragraphes Rouvrir le fichier téléchargé
6Enregistrer
Ouvrez le fichier obtenu puis contrôlez le texte et son ordre de lecture.
Exemple
Avant
Page visuelle
Après
Texte extrait
Vérifiez ces points dans le résultat
- Comparer noms, nombres et caractères spéciaux
- Contrôler l’ordre de lecture et les paragraphes
- Rouvrir le fichier téléchargé
Une base textuelle à reprendre
Le fichier rassemble le texte extrait sous des titres de page. Il peut servir de base pour une reprise éditoriale ou une consultation dans un navigateur. Il ne reconstruit pas les colonnes, tableaux, images ni le style graphique du PDF original.
Contrôler les passages complexes
L’ordre de lecture d’un PDF à plusieurs colonnes peut nécessiter des corrections. Relisez les listes, les notes et les unités avant de publier le contenu. Les chaînes ressemblant à du code HTML sont échappées afin de rester du texte dans le fichier exporté.
Questions fréquentes
Le résultat est-il une copie exacte du PDF ?
Non. C’est une exportation textuelle en HTML, pas une reproduction visuelle de la page.
Que faire si le PDF ne contient que des images ?
Ajoutez d’abord une couche de texte par reconnaissance, puis vérifiez-la. Sans texte lisible, cet export ne peut pas extraire le contenu écrit.