
In deze gids
Zo werkt het
Open een PDF met selecteerbare tekst. Voer voor een gescand document eerst OCR uit.
Kies PDF naar Word en start de export.
Open het DOCX-bestand in Word of een compatibele applicatie. Controleer de leesvolgorde, alinea's en speciale tekens.
Invoer, resultaat en grenzen
| Eigenschap | Details |
|---|---|
| Invoer | |
| Uitvoer | DOCX |
| Belangrijke beperking | Tekstuitvoer zonder reconstructie van afbeeldingen, tabellen of paginaopmaak. |
De werkwijze in zes beelden
1Invoer
Open een PDF met selecteerbare tekst. Voer voor een gescand document eerst OCR uit.
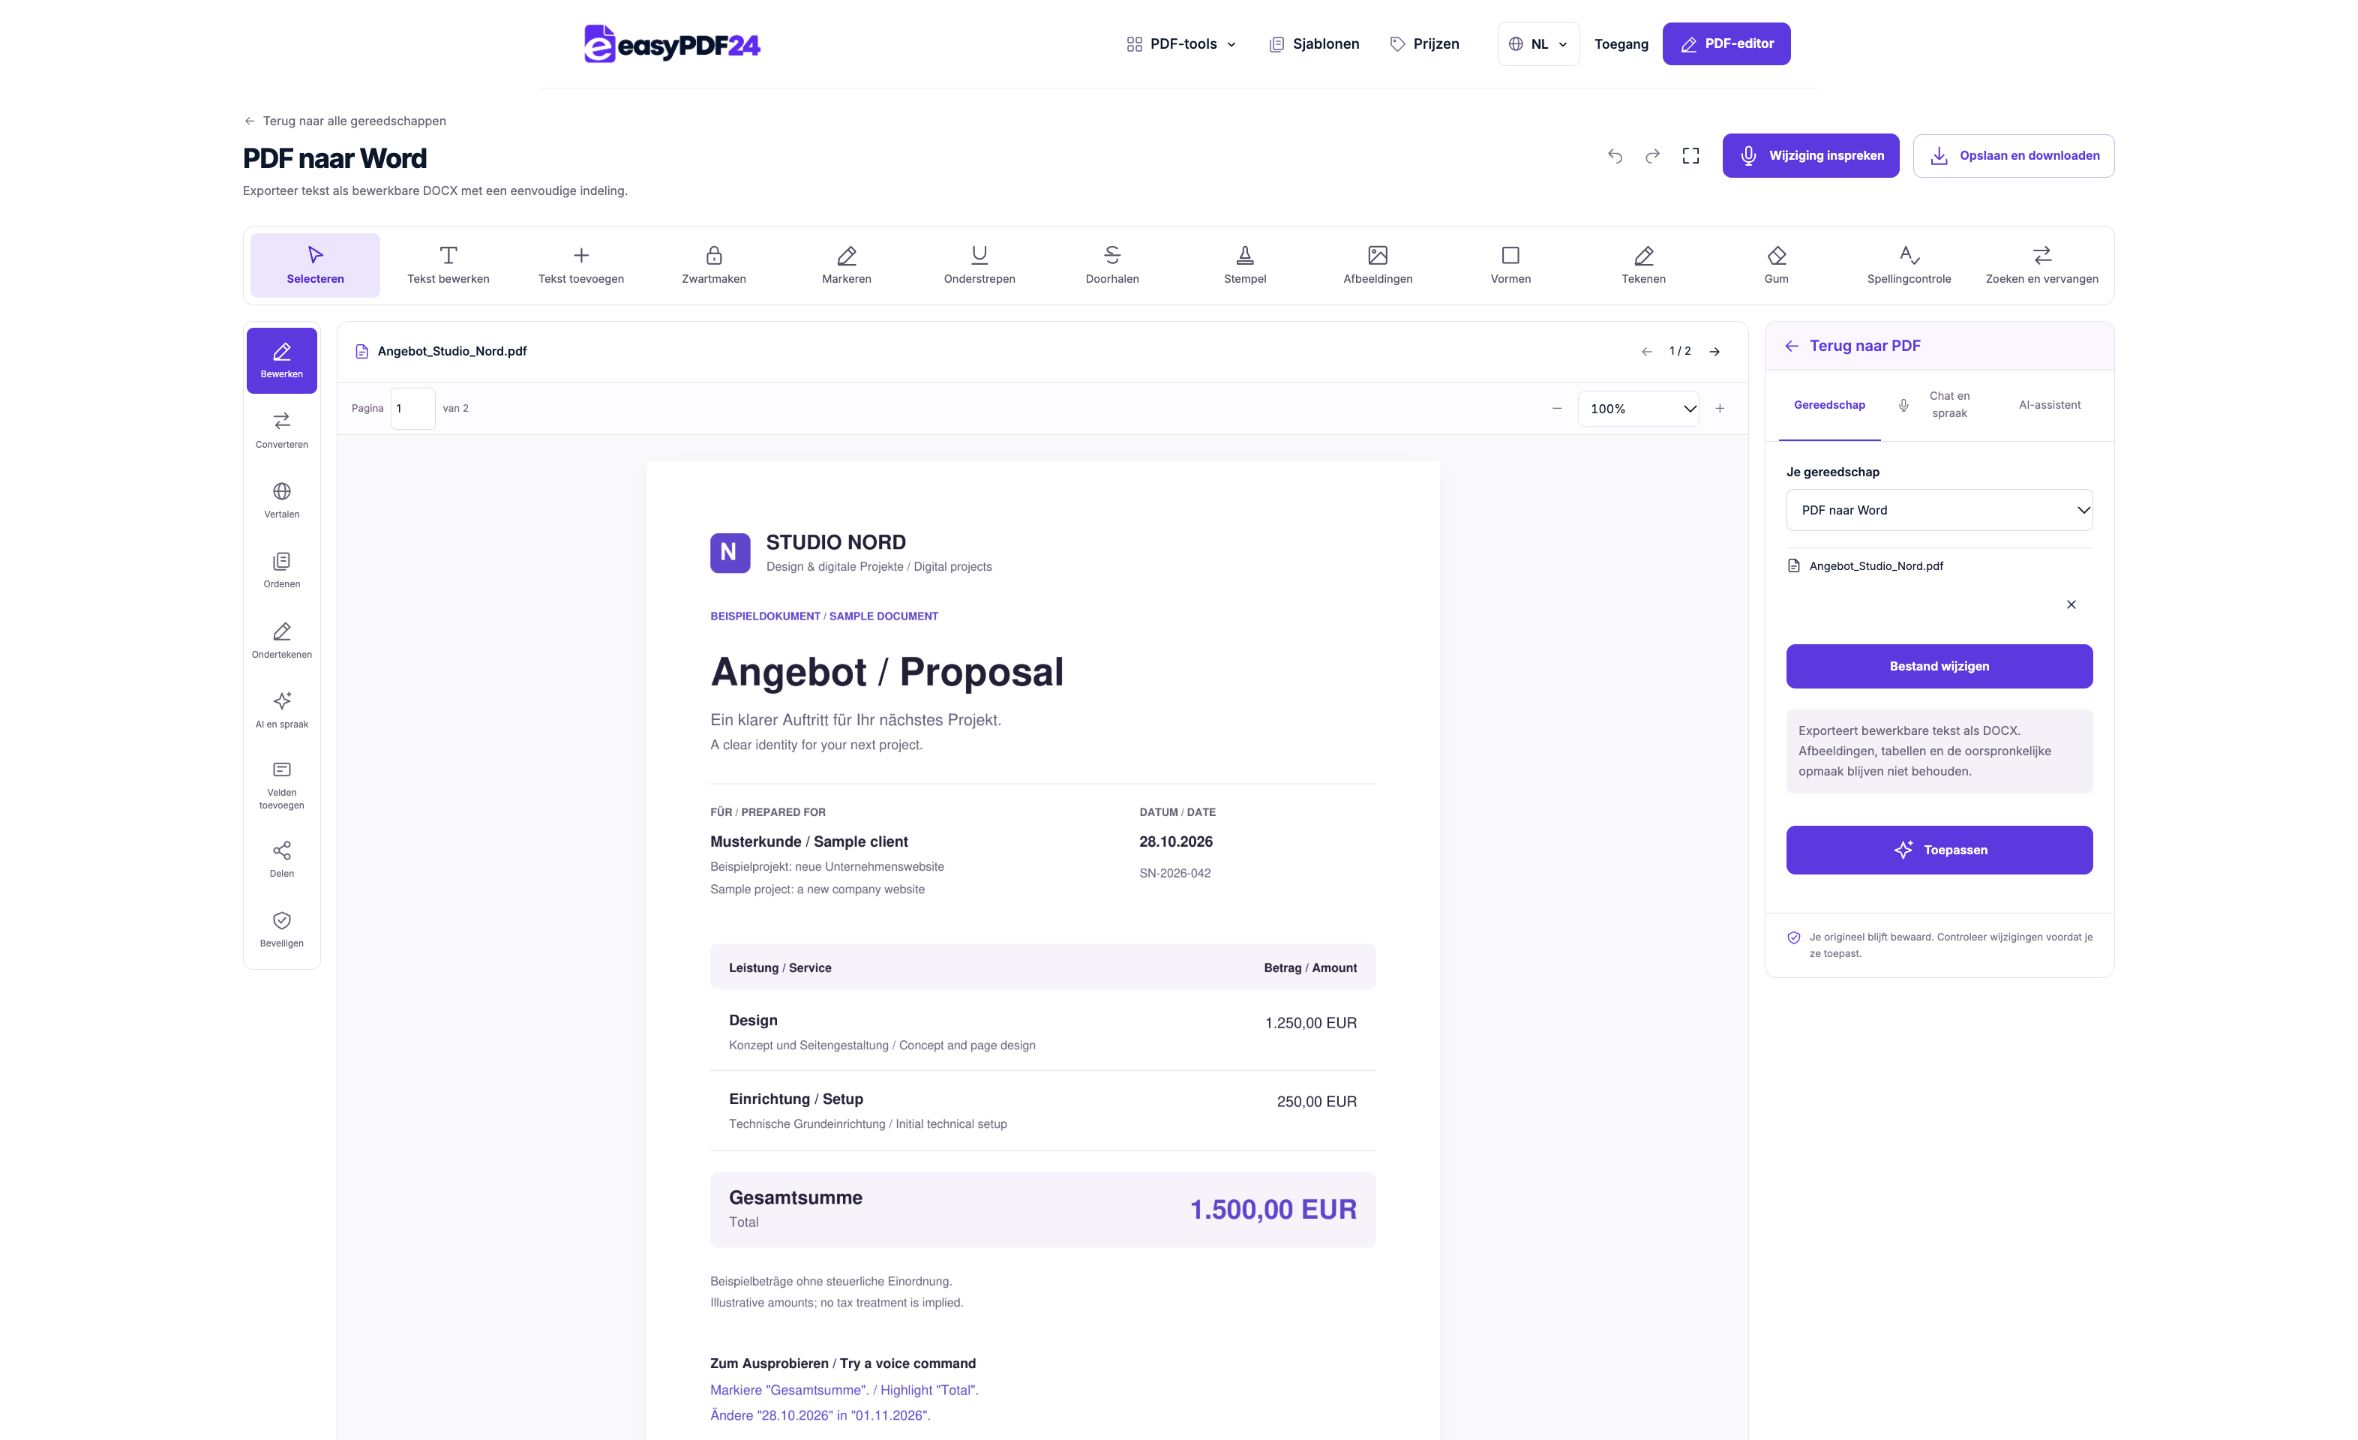
2Instellingen
Kies PDF naar Word en start de export.
3Toepassen
PDF → DOCX

4Voor en na
Visuele pagina → Bewerkbare inhoud
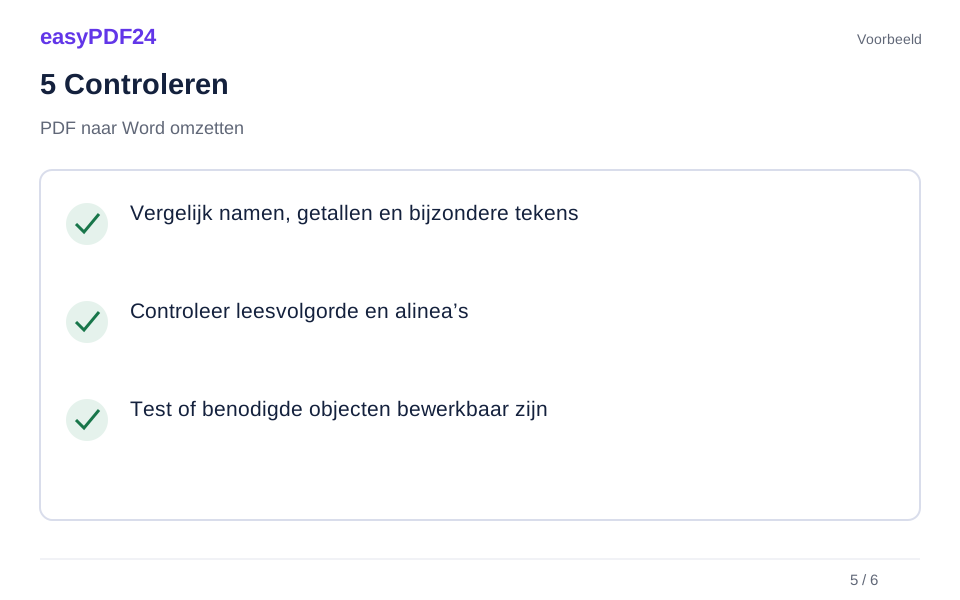
5Controleren
Vergelijk namen, getallen en bijzondere tekens Controleer leesvolgorde en alinea’s Test of benodigde objecten bewerkbaar zijn
6Opslaan
Open het DOCX-bestand in Word of een compatibele applicatie. Controleer de leesvolgorde, alinea's en speciale tekens.
Voorbeeld
Voor
Visuele pagina
Na
Bewerkbare inhoud
Controleer deze punten in het resultaat
- Vergelijk namen, getallen en bijzondere tekens
- Controleer leesvolgorde en alinea’s
- Test of benodigde objecten bewerkbaar zijn
Kies een tekstexport als herschrijven de echte taak is
Het converteren van een PDF naar Word is handig als je met de tekst ervan in een documenteditor moet werken. Misschien wil je je notities reorganiseren, een lange uitleg herschrijven of een passage in een nieuw document hergebruiken. easyPDF24 exporteert bestaande selecteerbare PDF-tekst naar een standaard DOCX-bestand. Dit geeft je bewerkbare tekst om mee te werken, maar het is geen belofte om het originele paginaontwerp te reproduceren. Maak dat onderscheid voordat je besluit of conversie de juiste volgende stap is.
Als je slechts één datum, een korte naam of een enkele zin op de bestaande locatie hoeft te wijzigen, kan directe PDF-bewerking een kortere route zijn. Conversie gevolgd door het opnieuw opbouwen en exporteren van een nieuwe PDF biedt meer mogelijkheden voor lay-outverschillen. Als je meerdere alinea's moet herschrijven, koppen moet wijzigen of secties moet reorganiseren, is werken in Word of een andere compatibele documenteditor vaak geschikter. Als de oorspronkelijke bewerkbare bron bestaat, gebruik deze dan indien mogelijk. Een nieuwe kopie van die bron zal doorgaans meer van de structuur van de auteur behouden dan tekst die uit een voltooide PDF is hersteld.
Controleer of de PDF bruikbare tekst bevat
Open de pdf en probeer een zin te selecteren en te kopiëren. Een succesvolle selectie suggereert dat het document een tekstlaag heeft, maar controleer ook het geplakte resultaat. Sommige bestanden geven correct uitziende tekst weer, terwijl ongebruikelijke tekentoewijzingen of een leesvolgorde worden opgeslagen die afwijkt van de visuele lay-out. Een korte kopieer- en plakcontrole kan ontbrekende letters, onverwachte spaties of woorden die in de verkeerde volgorde verschijnen aan het licht brengen voordat je het hele document converteert.
Een gescande pagina mag alleen een afbeelding of tekst bevatten. In dat geval kan de export geen gewone tekst herstellen door alleen de bestandsextensie te wijzigen. Ondersteunde OCR kan een herkende tekstlaag toevoegen aan Duits- of Engelstalige afgedrukte scans. Voer indien nodig eerst OCR uit en controleer vervolgens de herkende tekst op de zichtbare pagina. Namen, cijfers, data en speciale tekens verdienen bijzondere aandacht. OCR is een herkenningsstap met mogelijke fouten, geen garantie dat de bron een nauwkeurig gestructureerd Word-document is geworden. Als de scan wazig, gekanteld of gedeeltelijk onduidelijk is, kan het verbeteren van de bronafbeelding nuttiger zijn dan het herhaaldelijk converteren van dezelfde onzekere tekst.
Begrijp wat de DOCX-uitvoer bevat
De huidige export neemt tekst uit de PDF en plaatst deze in een eenvoudig Word-document. Het neemt de originele afbeeldingen niet over, maakt geen tabellen opnieuw als bewerkbare Word-tabellen en behoudt de volledige pagina-indeling niet. Tekstregels worden eenvoudige alinea's en paginagrenzen vanaf de bron worden weergegeven door pagina-einden. Deze structuur is een startpunt voor het redigeren van de tekst, en niet zozeer een voltooide reconstructie van een ontworpen brochure, formulier of presentatie.
Dat gedrag kan nuttig zijn als het je doel is de tekst opnieuw te gebruiken zonder een complexe lay-out over te nemen. Het betekent ook dat je tijd moet vrijmaken voor het opruimen. Een alinea die meerdere regels in de PDF beslaat, kan in de DOCX als verschillende afzonderlijke alinea's verschijnen. Een tabel kan als tekst binnenkomen waarvan de relaties handmatig opnieuw moeten worden opgebouwd. Bedenk voordat je een groot document exporteert hoeveel structuur je daadwerkelijk nodig hebt. Als het resultaat nauwkeurig moet overeenkomen met een goed ontworpen origineel, lokaliseer dan het brondocument of gebruik een workflow die geschikt is voor die reconstructie in plaats van te verwachten dat deze tekstgeoriënteerde export het automatisch levert.
Voer de conversie uit en inspecteer een representatieve pagina
Open de beoogde PDF in PDF naar Word en start de export. Houd het origineel beschikbaar terwijl je de DOCX bekijkt. Open het gedownloade bestand in Word of een compatibele applicatie en inspecteer een representatief gedeelte voordat je het uitgebreid gaat bewerken. Kies een sectie met een kop, gewone tekst en eventuele lay-outkenmerken die belangrijk zijn voor je taak. Vergelijk de bewoording met de PDF in plaats van alleen te controleren of de DOCX succesvol wordt geopend.
Begin met het begin en einde van het document en kijk vervolgens naar secties met kolommen, tabellen of speciale tekens. Dit geeft je al vroeg een idee van de vereiste opruiming. Als de tekst grotendeels correct is, maar de alineagrenzen onhandig zijn, kun je de structuur in de tekstverwerker herstellen. Als hele secties ontbreken omdat het afbeeldingen zijn, ga dan terug naar de pdf en beoordeel of ondersteunde OCR geschikt is. Als tekens slecht gecodeerd zijn, kan een andere bron of export nodig zijn. Als je het probleem vroegtijdig identificeert, voorkom je dat je de eerste pagina van een document waarvan de resterende inhoud niet op betrouwbare wijze is hersteld, kunt oppoetsen.
Bouw alinea's en kopjes bewust opnieuw op
Nadat je de bewoording hebt bevestigd, deel je de tekst in in bruikbare paragrafen. PDF-regels geven aan waar tekst op een vaste pagina paste; het zijn niet altijd betekenisvolle alineagrenzen. Voeg regels samen die bij dezelfde alinea horen en verwijder de onderbrekingen die een zin onderbreken. Controleer de afgebroken woorden aan het einde van de regel zorgvuldig. Mogelijk maakt een koppelteken deel uit van het woord, of is het alleen ingevoegd omdat het woord een lijngrens in de bronlay-out heeft overschreden.
Pas kopstijlen toe in de tekstverwerker als het document een duidelijke hiërarchie nodig heeft. Een visueel grote regel in de PDF wordt niet automatisch geëxporteerd als een gestructureerde Word-kop. Bepaal welke regels titels, sectiekoppen, bijschriften of gewone hoofdtekst zijn. Consistente stijlen maken latere bewerking eenvoudiger en helpen een samenhangend uiterlijk te behouden wanneer tekst wordt toegevoegd of verwijderd. Doe dit nadat je de geëxtraheerde bewoording hebt gecontroleerd, zodat de opmaak je niet afleidt van ontbrekende of onjuiste inhoud. Houd de PDF open als referentie terwijl je de structuur opnieuw opbouwt, maar laat het nieuwe document op natuurlijke wijze vloeien in plaats van elke regel te dwingen precies daar te eindigen waar deze in de bron eindigde.
Behandel kolommen, tabellen en voetnoten als afzonderlijke controles
Pagina's met meerdere kolommen kunnen een extractievolgorde opleveren die verschilt van de volgorde die een persoon visueel volgt. Een zin uit de rechterkolom kan tussen de regels van de linkerkolom verschijnen, of er kan een zijbalk in de hoofdtekst worden gemengd. Vergelijk de eerste en laatste zin van elke kolom en lees het geconverteerde gedeelte voortdurend. Als het verhaal onverwachts verspringt, inspecteer dan de bronpagina en verplaats de relevante tekst in de juiste volgorde voordat je verdere redactionele wijzigingen aanbrengt.
Tabellen vereisen een ander soort beoordeling. Bij de DOCX-export wordt geen bewerkbare tabel opnieuw gemaakt met de originele cellen en randen. Controleer welke labels bij welke waarden horen en bouw de tabel handmatig opnieuw op als je die structuur nodig hebt. Let vooral op decimale waarden, eenheden en kopjes die op meerdere kolommen van toepassing zijn. Voetnoten, bijschriften en herhaalde kopteksten kunnen ook tussen de geëxtraheerde regels verschijnen. Bewaar ze alleen daar waar ze het doel van het nieuwe document dienen, en verifieer de referenties nadat je ze hebt verplaatst. Een tekstexport kan nuttige bewoordingen terughalen, terwijl je nog steeds de relaties moet reconstrueren die de originele pagina via de lay-out communiceerde.
Controleer namen, cijfers en herkende tekens
Beperk het proeflezen niet tot gewone spelling. Controleer persoons- en organisatienamen, referentiecodes, data, bedragen en eenheden ten opzichte van de PDF. Eén enkel verkeerd teken kan een verwijzing of waarde veranderen, zelfs als de omringende alinea soepel leest. Dit is vooral belangrijk na OCR, waarbij op elkaar lijkende tekens, zoals letters en cijfers, met elkaar verward kunnen worden. Vergelijk de zichtbare bron in plaats van aan te nemen dat een spellingcontrole gespecialiseerde termen of numerieke informatie kan valideren.
Zoek in het Word-document naar enkele opvallende zinsneden uit verschillende delen van de PDF. Dit kan helpen ontbrekende secties aan het licht te brengen, maar het vervangt geen systematische controle van belangrijke inhoud. Als de PDF wiskundige notatie, ongebruikelijke symbolen of een gespecialiseerd alfabet bevat, kun je die passages rechtstreeks inspecteren. Het is mogelijk dat een basistekstexport de beoogde weergave ervan niet behoudt. Markeer onzekere passages ter beoordeling in plaats van stilzwijgend te raden wat de auteur bedoelde. Wanneer je de formulering na de conversie bewerkt, moet je een duidelijk onderscheid maken tussen het corrigeren van extractiefouten en het opzettelijk aanbrengen van wijzigingen in de inhoud, zodat je kunt uitleggen welke verschillen voortkomen uit de export en welke je eigen revisies waren.
Gebruik een praktijkvoorbeeld om de opruiming te plannen
Stel dat je een workshophand-out van zes pagina's hebt en de instructies ervan wilt omzetten in een herzien trainingsdocument. De hand-out bevat gewone tekst, een checklist met twee kolommen en diverse illustraties. Exporteer de selecteerbare tekst en vergelijk vervolgens de herstelde instructies met de PDF. Voeg waar nodig lijngebaseerde paragrafen samen en pas een consistente kopstructuur toe. Bouw de checklist opnieuw op als een tabel of lijst in de tekstverwerker, gebaseerd op de relaties die op de originele pagina worden weergegeven.
De illustraties zijn niet opgenomen in deze tekstexport, dus bepaal of het nieuwe document deze nodig heeft. Verkrijg geschikte bronafbeeldingen of bereid een geschikte afbeeldingsworkflow voor in plaats van aan te nemen dat deze later in de conversie zullen verschijnen. Als je een gerenderde PDF-pagina als afbeelding gebruikt, moet je er rekening mee houden dat het een afbeelding van de pagina is en geen bewerkbare reconstructie van de afzonderlijke objecten. Zodra de tekst en afbeeldingen zijn samengesteld, bekijk je het nieuwe document als een eigen publicatie. Het moet de bijgewerkte instructies duidelijk communiceren en niet in één oogopslag op de oude pagina lijken, terwijl deze gebroken paragrafen of niet-overeenkomende checklistwaarden bevat.
Ga om met moeilijke resultaten zonder herhaaldelijk blindelings te converteren
Als de DOCX leeg is of weinig tekst bevat, controleer dan of de PDF op afbeeldingen is gebaseerd. Als de tekst door elkaar gegooid is, controleer dan de leesvolgorde en ongebruikelijke tekencodering. Als de bewoording correct is, maar de lay-out er anders uitziet, onthoud dan dat deze tool opzettelijk een basistekstdocument produceert. Dit zijn verschillende situaties en vereisen verschillende reacties. Het is onwaarschijnlijk dat het herhalen van dezelfde export zonder de bron of de workflow te wijzigen het onderliggende probleem oplost.
Voor een ondersteunde scan voer je OCR uit op de relevante pagina's en controleer je het resultaat voordat je opnieuw exporteert. Voor een complexe lay-out moet je beslissen of handmatig opschonen redelijk is of dat het vinden van de oorspronkelijke bron tijd zou besparen. Voor een kleine correctie kun je terugkeren naar directe PDF-bewerking in plaats van onnodig een heel document te reconstrueren. Bewaar een werkkopie van de DOCX terwijl je experimenteert met de opmaak, en bewaar de originele PDF als referentie. Als de ontvangende taak een exacte visuele match vereist, test die vereiste dan vroeg. Een succesvol tekstherstel en een exacte paginareproductie zijn verschillende uitkomsten, en deze export is rond de eerste ontworpen.
Maak het Word-document af voordat je een nieuwe PDF maakt
Nadat je de tekst hebt gecorrigeerd en de noodzakelijke structuur opnieuw hebt opgebouwd, bekijk je het document in de tekstverwerker. Controleer koppen, alinea-afstand, tabellen, pagina-einden en eventuele nieuw toegevoegde afbeeldingen. Verwijder herhaalde kopteksten of regeleinden die niet langer zinvol zijn in de nieuwe lay-out. Lees het document voortdurend om overgangen op te sporen die werden verstoord door de oorspronkelijke extractie van vaste pagina's. Sla de bewerkbare DOCX op als de nieuwe werkbron als je van plan bent deze later te onderhouden.
Als je het eindresultaat als PDF wilt delen, exporteert je het vanuit de tekstverwerker of gebruik je Office naar PDF voor een ondersteund bestand, en inspecteer je vervolgens de nieuwe PDF afzonderlijk. Lettertypen en paginering kunnen per conversieomgeving verschillen. Een volledige conversieworkflow eindigt met nauwkeurige, bruikbare tekst en een gecontroleerde uitvoer in het formaat dat je ontvanger daadwerkelijk nodig heeft.
Veelgestelde vragen
Zal het Word-bestand er precies zo uitzien als de PDF?
Nee. Met deze export wordt tekst gemaakt met eenvoudige opmaak. Complexe tabellen, beeldpositionering en exacte pagina-einden vergen afzonderlijk werk.
Kan ik het DOCX-bestand weer omzetten in een PDF?
Ja. Gebruik de PDF-export in je tekstverwerker of de easyPDF24 Office naar PDF-tool.
Waarom wordt één alinea meerdere alinea's in Word?
De export volgt tekstregels die zijn geëxtraheerd uit de vaste PDF-pagina. Een regel die eindigt in die bron is niet altijd een echte alineagrens, dus de basis-DOCX kan meerdere korte alinea's bevatten waarvan je één vloeiende passage verwachtte. Vergelijk de tekst met de pdf en voeg regels samen die bij elkaar horen. Controleer de afbreekstreepjes aan het einde van de regel voordat je ze verwijdert, omdat sommige deel uitmaken van het woord en geen lay-outartefact zijn. Pas kop- en alineastijlen toe nadat je de structuur hebt hersteld.
Zal de conversie het originele Word-bronbestand herstellen?
Nee. Er wordt een nieuwe DOCX gemaakt van de beschikbare PDF-tekst. Het herstelt niet het originele auteursbestand, de bewerkingsgeschiedenis of de volledige lay-outstructuur. Als die bron beschikbaar is, gebruik deze dan voor substantiële herzieningen. De export is handig wanneer de PDF je beschikbare referentie is en bewerkbare bewoordingen de belangrijkste vereiste zijn.